如何用 Office 文档直接构建企业 AI 知识库?
企业里其实从来不缺文档,缺的是一种让 AI 真正“读懂”这些文档的方法。产品手册、项目方案、FAQ、交付记录都已经存在,但一旦要让 AI 准确回答真实业务问题,传统知识库的搭建往往又绕回切片、向量化和向量数据库。
SourceLens 是一个开源项目:不需要向量数据库,就能直接把企业文档变成可问答的知识库。它最早解决的,是一个非常具体的问题:如何让 AI 更准确地回答企业内部真实的产品和项目问题。
以 HyperBDR 为例,售前、交付和售后每天都会遇到大量类似问题:某个 Linux 版本是否支持,某个 VMware 环境迁移到目标云平台应该采用 Agent 还是 Agentless,某个限制来自产品本身还是项目配置。这些答案通常已经存在,只是分散在产品文档、Wiki、PPT、Word、PDF、FAQ、项目资料、会议纪要甚至代码里。
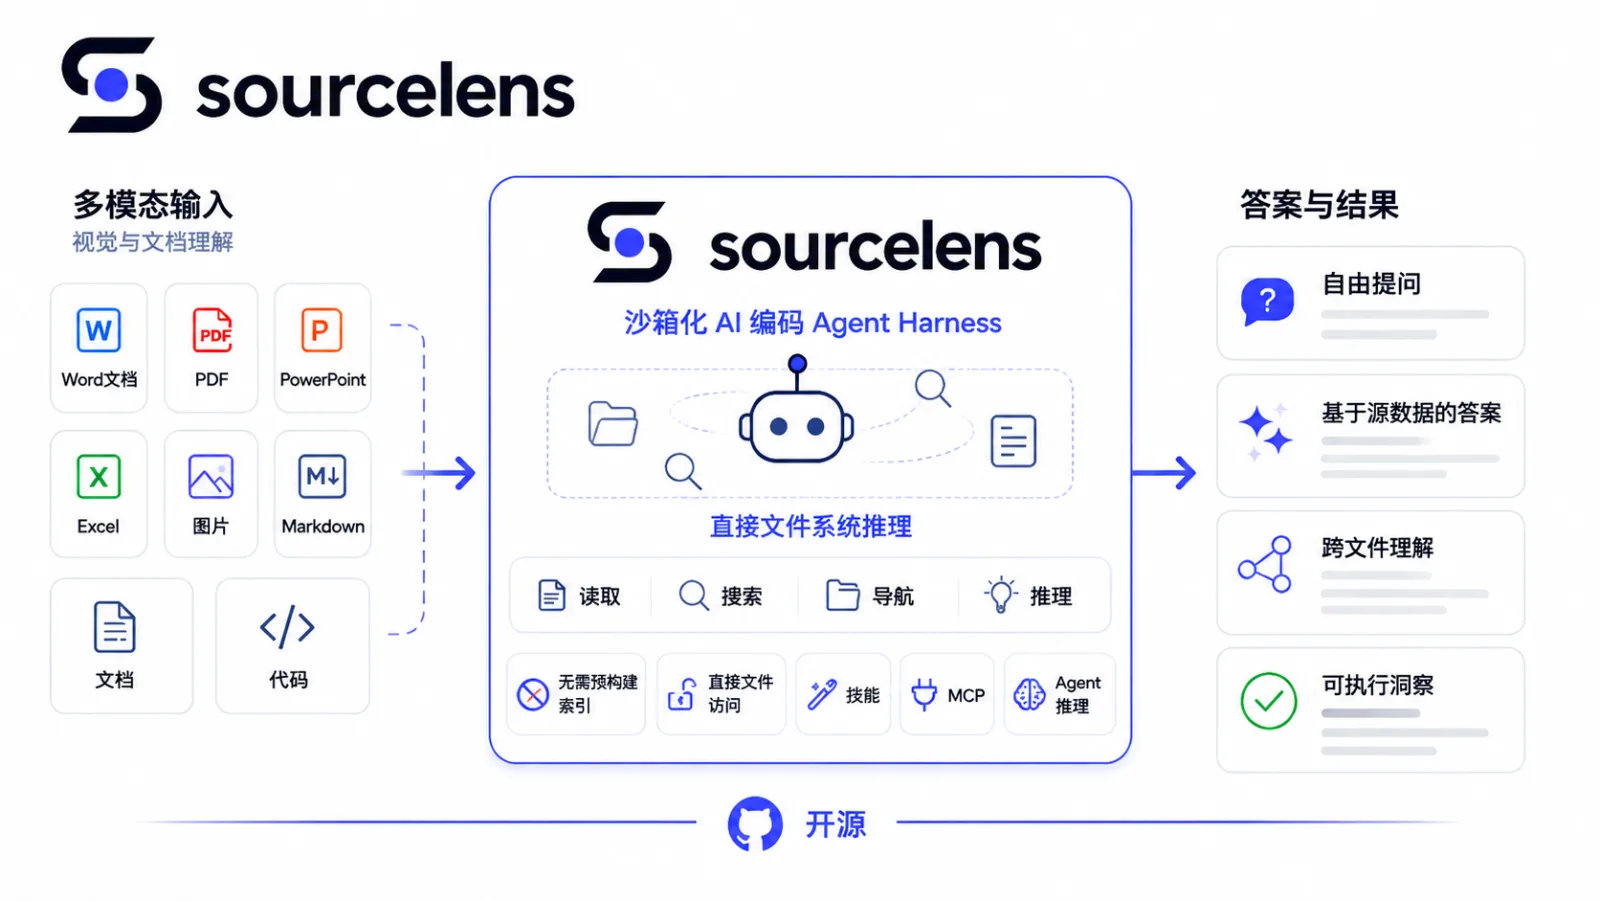
SourceLens 的整体思路:不预处理、不建索引,让 Agent 直接进入原始文件搜索、阅读、推理
对于做了很多年的资深工程师来说,很多问题并不难,他知道该去哪里找,也知道哪些文档需要组合起来看。但这种能力往往依赖长期积累的经验,新人很难在短时间内建立同样完整的知识体系,而且产品、版本和项目经验还在持续变化,靠培训和人工传递很难一直跟上。我们真正想解决的,其实是怎么把这种原本依赖个人经验的能力,变成所有人都能直接使用的企业能力。
我们现在的做法很直接:把这些资料同步到 SourceLens,建立面向特定业务的助手(Assistant),用户直接提问。比如"HyperBDR 是否支持 Ubuntu 24.04",或者"客户是 VMware 7、Windows 和 Linux 混合环境,要迁移到目标云平台,应该采用什么方案,有哪些限制"。SourceLens 会自己搜索相关资料、读取上下文、继续沿线索查找,再基于找到的关键证据给出结论,主打一个有理有据不胡说八道。
这里真正重要的不是 AI 能不能回答,而是答案有没有依据。企业场景里,我们更希望系统明确告诉用户它参考了哪些资料、为什么得出这个结论;如果证据不足,就直接说无法确认,而不是依赖模型原有知识自由发挥。
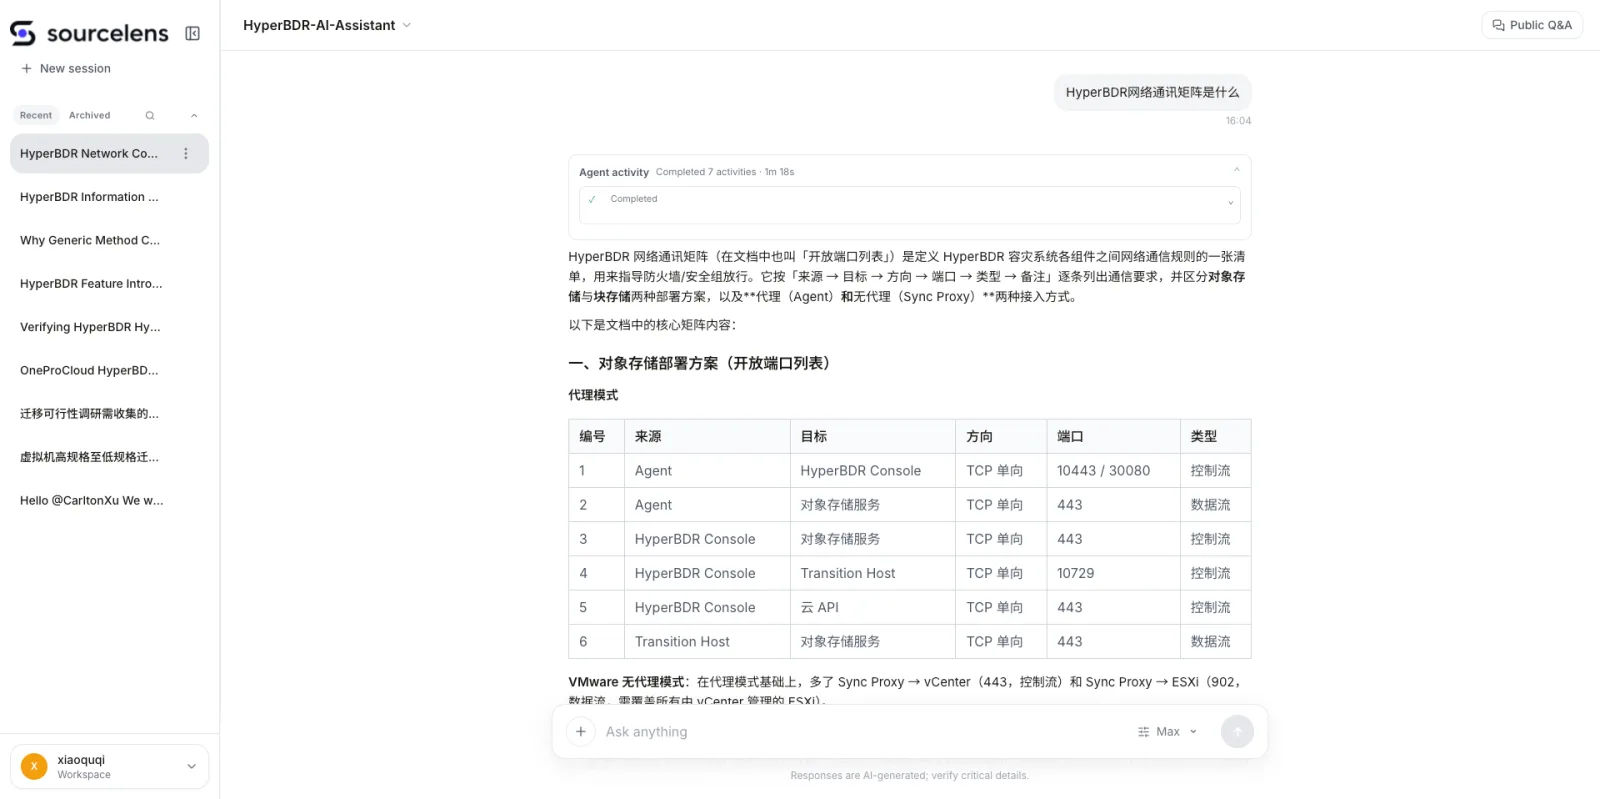
中文提问,中文回答
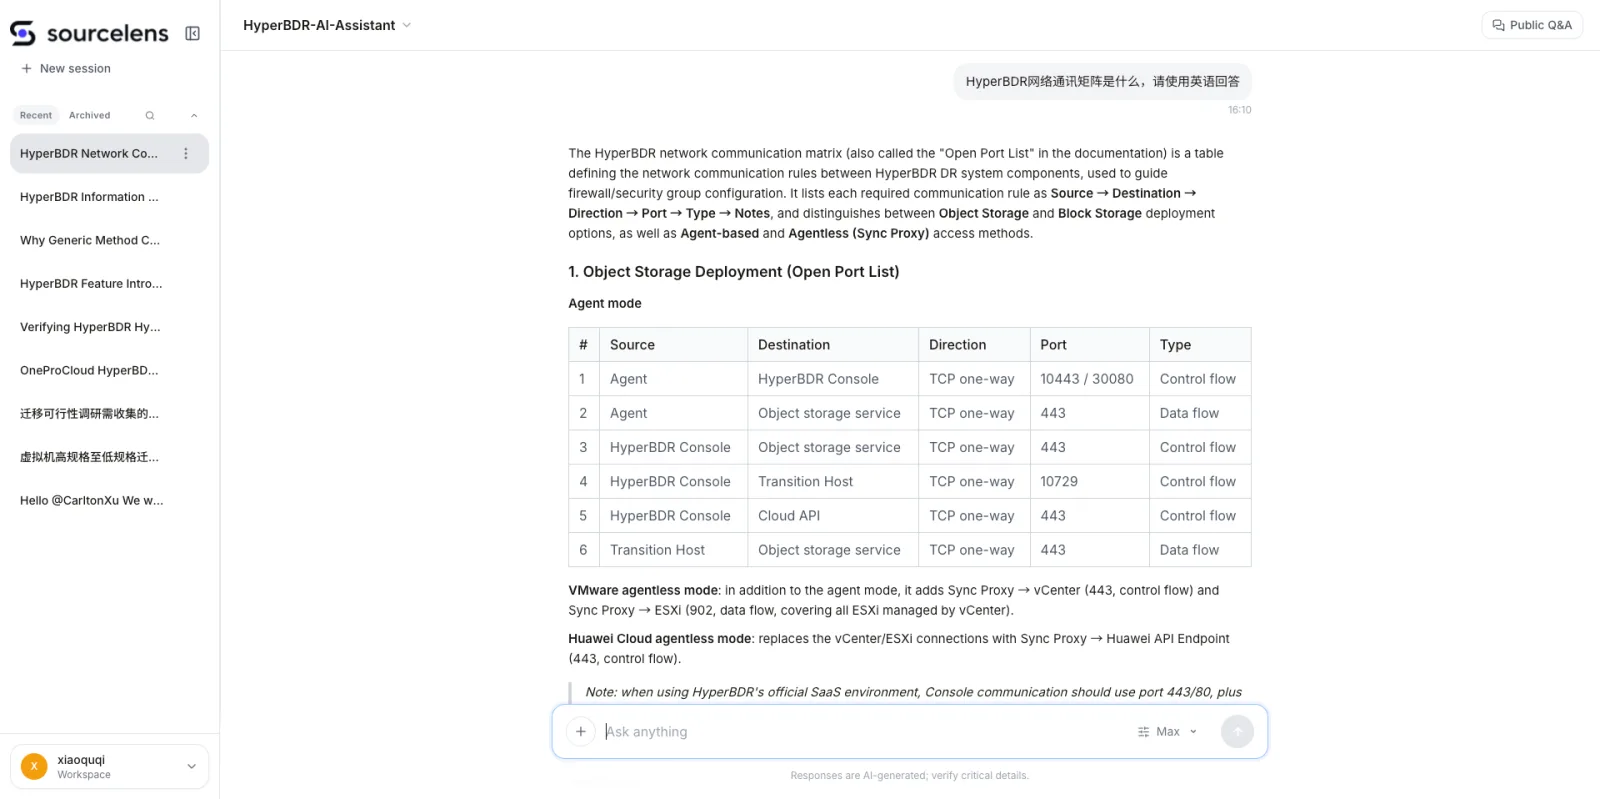
中文提问,指定用英文回答
从传统 RAG 到 SourceLens:我们为什么换了一条路
我们最早做企业知识问答时,走的也是当时最主流的 RAG 路线。表面上看,这件事并不复杂:拖拉拽搭一个工作流,把知识库接到大模型上,很快就能跑起来。但真正做过之后会发现,最难的根本不是后面的流程,而是前面那一步——怎么把企业原始文档变成一个真正可用的向量知识库。
当时市面上已经有不少所谓的 RAG 工具,但它们大多解决的是流程编排,并没有真正解决企业文档如何解析、切分和组织的问题。PDF、Word、PPT 的结构差异很大,同一份文档里可能既有标题、表格,也有图片和长段落;切得太碎,上下文会丢失,切得太大,检索又不准。最后我们不得不自己开发外部脚本,对不同类型的资料做解析、清洗和切分,再反复调整 Embedding 和召回策略。
在我们当时的内部实践中,从开始研究到真正上线前后大约花了四个月,其中至少三个月都在反复实验"怎么切"。不同文档需要不同策略,同一个问题换一种切分方式,召回结果就可能完全不同。经过大量测试后,我们才把部分内部场景的准确率做到大约 80%。所以后来我们反思 RAG,并不是因为这条路没有做下去,而恰恰是因为我们真正把它从研究做到上线,才看清了它的工程成本和边界。
继续往后走时,我们逐渐发现另一个更根本的问题:即使切分和召回已经做得不错,复杂问题依然很难稳定回答。因为很多企业问题的答案并不完整存在于某一个 Chunk 中,而是分散在不同文档、不同章节甚至不同类型的数据里。AI 需要先理解问题,再找到第一条线索,继续补充上下文,最后把多个信息组合起来形成判断。到了这里,问题已经不只是 Retrieval,而更像一个调查和推理过程。
真正给我们很大启发的是 Cursor。我们使用 Cursor 分析代码问题时,最受启发的并不是它底层到底采用了什么索引技术,而是它展现出来的工作方式:Agent 会先理解问题,然后搜索关键词、打开相关文件、阅读上下文,再根据新的线索继续查找。整个过程其实很朴素,本质上就是 Search、Read、Reason,再 Search。
这个方式让我们开始重新思考一个问题:如果 Cursor 可以这样阅读一个复杂的代码仓库,为什么不能用同样的方法阅读企业文档?
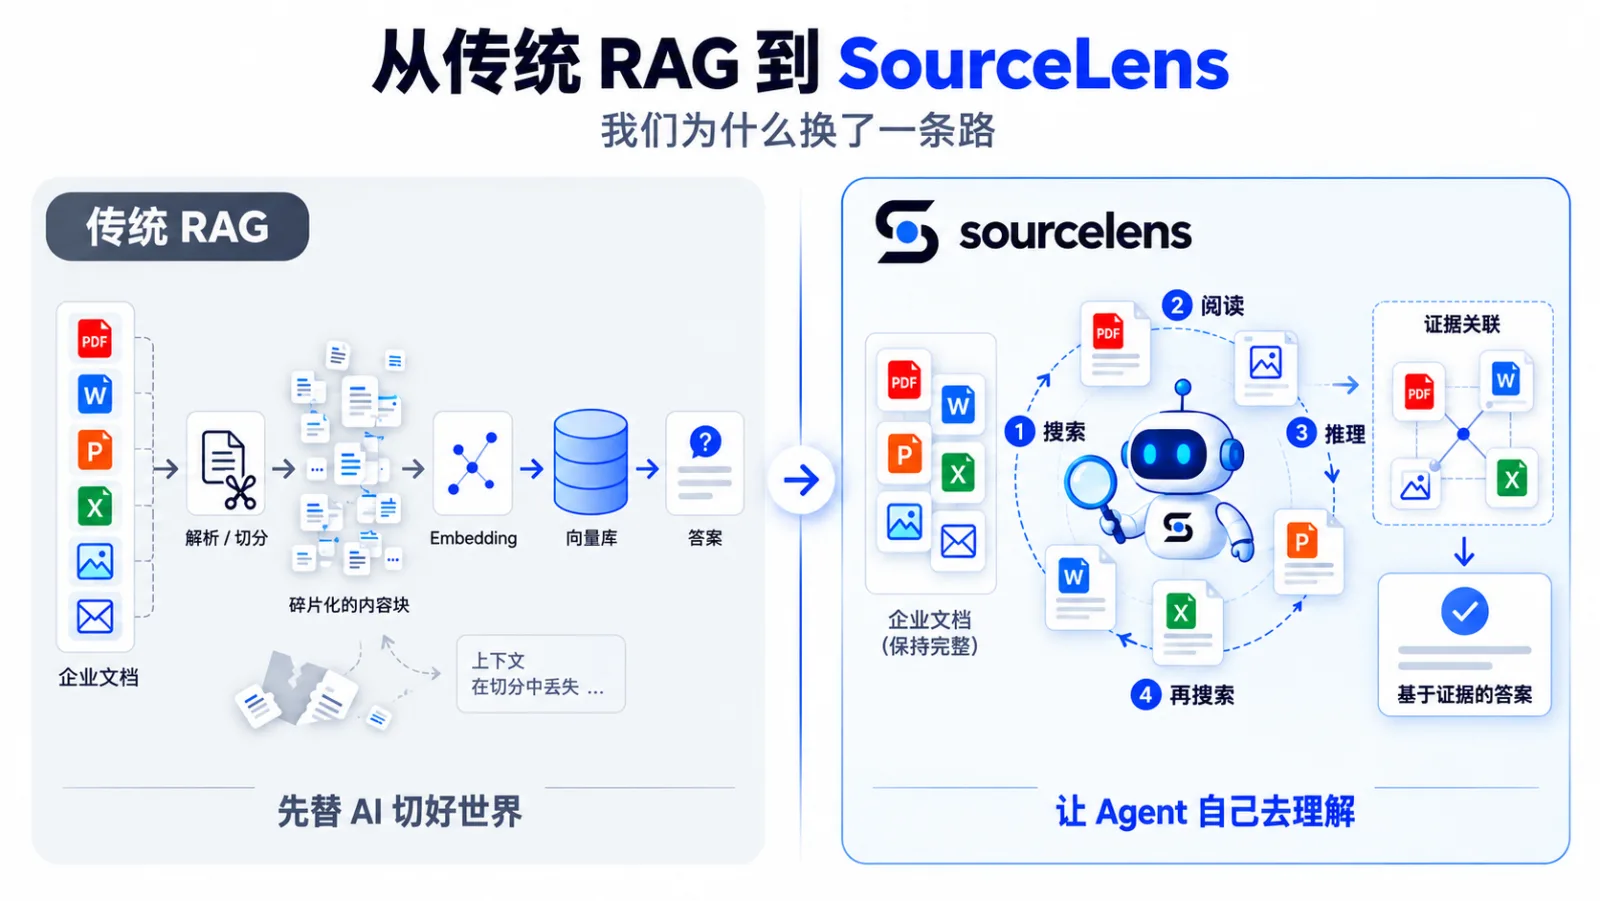
传统 RAG 先替 AI 切好世界;SourceLens 让 Agent 自己去理解
于是我们才开始设计 SourceLens。这个名字本身也代表了我们当时最核心的想法:从源数据(Source)直接获得洞察(Lens)。不是先把所有企业资料重新组织成另一套知识体系,再让 AI 去查询,而是尽可能保留原始数据和上下文,让 Agent 直接进入数据中搜索、阅读、关联和推理。
这也让 SourceLens 的设计开始和传统 RAG 走向不同的方向。我们不再把 Vector Retrieval 当成企业文件理解的唯一入口,而是把 Harness / Agent Engine 放到更核心的位置。Agent 根据问题主动决定需要查什么,搜索相关资料,读取上下文,再沿着新的线索继续查找,最终基于证据形成答案。
不过,企业文档和代码之间还有一个很大的区别。代码天然就是 Agent 比较容易读取和搜索的文本,而企业数据大量存在于 PPT、Word、PDF、Excel、图片、扫描件、邮件和各种附件中,很多重要信息甚至只存在于一张图里。因此 SourceLens 不要求用户提前切分、Embedding 或建立索引,但系统内部仍然会完成必要的文件解析和标准化,把这些复杂格式转换成更适合 Agent 搜索、阅读和推理的数据 Context。
这也是我们后来对这件事最直接的理解:传统 RAG 很大一部分工程工作,是提前替 AI 决定数据应该怎么被拆、怎么被索引;而 SourceLens 更希望把一部分判断权重新交给 Agent,让它根据具体问题决定下一步该找什么。
SourceLens 最终形成的设计也很简单:数据 → 预处理 / 治理 → 上下文 → Harness Engine → Skills → 助手。 Harness Engine 和模型都可以不断变化,但企业真正需要长期沉淀的,是自己的数据、权限、Skills、Workflow 和 Evidence。
快速体验
真正使用 SourceLens,可以压缩成三步:安装并配置模型、上传数据并创建助手、提问并查看回答——SourceLens 自己的引导页也是这么设计的。
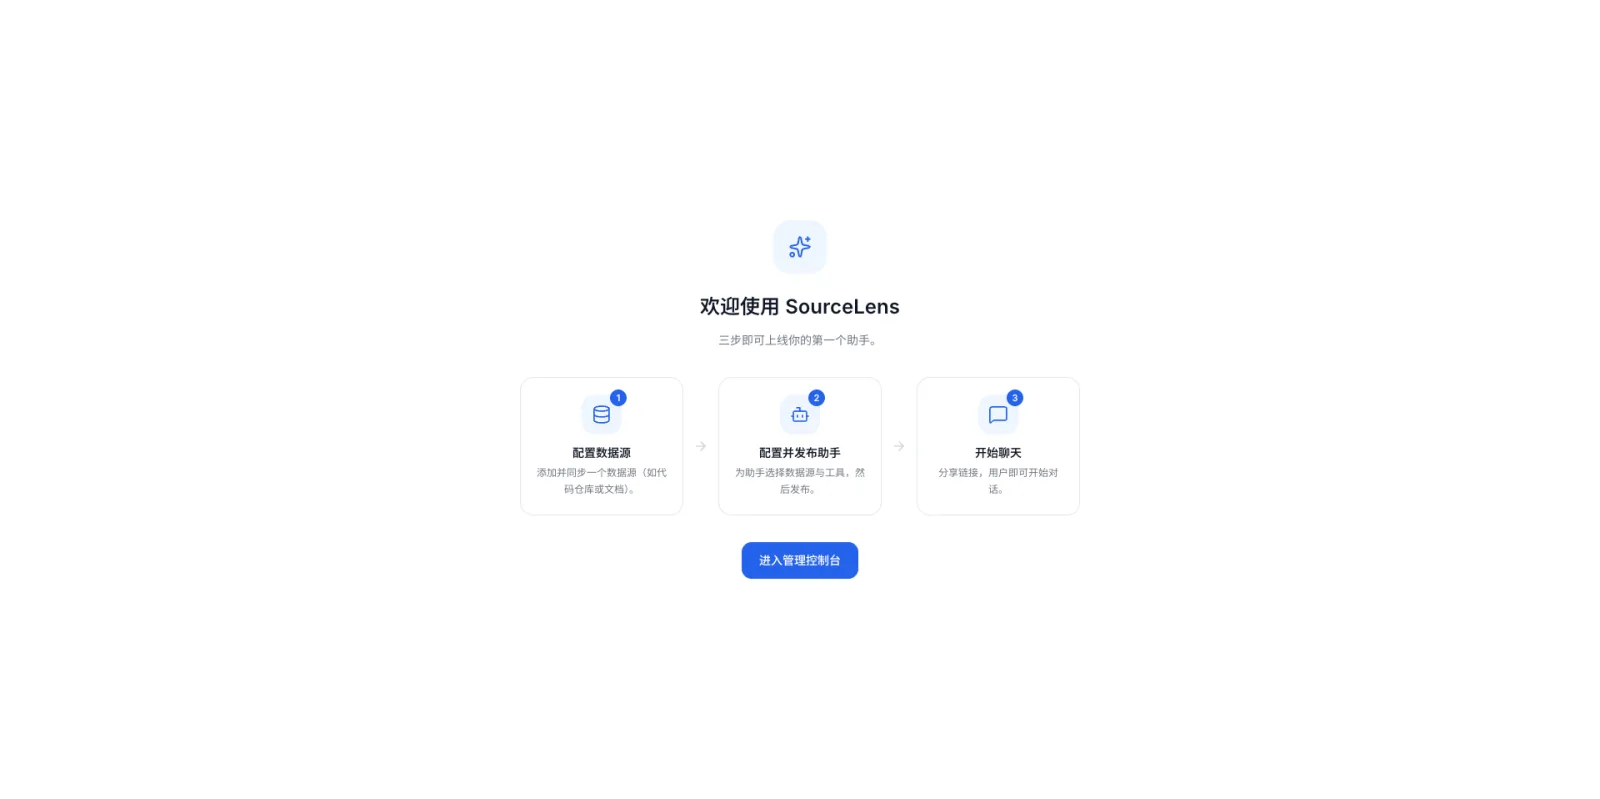
首次登录会看到这个引导页,三步上线第一个助手
第一步:安装并配置模型
建议准备一台 4 核 CPU、8 GB 内存、100 GB 磁盘空间的机器(Linux、macOS 或装了 Docker Desktop 的 Windows 都行),并提前装好 Docker Compose V2。
国内网络(推荐):
curl -fsSL \
  https://gitee.com/oneprolabs/sourcelens/raw/main/install.sh \
  | sudo bash -s -- --channel cn --download-source gitee
海外网络:
curl -fsSL \
  https://raw.githubusercontent.com/oneprolabs/sourcelens/main/install.sh \
  | sudo bash
装完用这条命令确认服务已经起来:
curl -f http://<host>:10083/health浏览器打开 http://<host>:10083,用户名 admin,密码在安装目录下的 install-info.env 里,登录后进入模型配置——这里需要两个模型的 API Key:一个负责聊天和检索(比如 DeepSeek),一个负责识别图片等视觉输入。
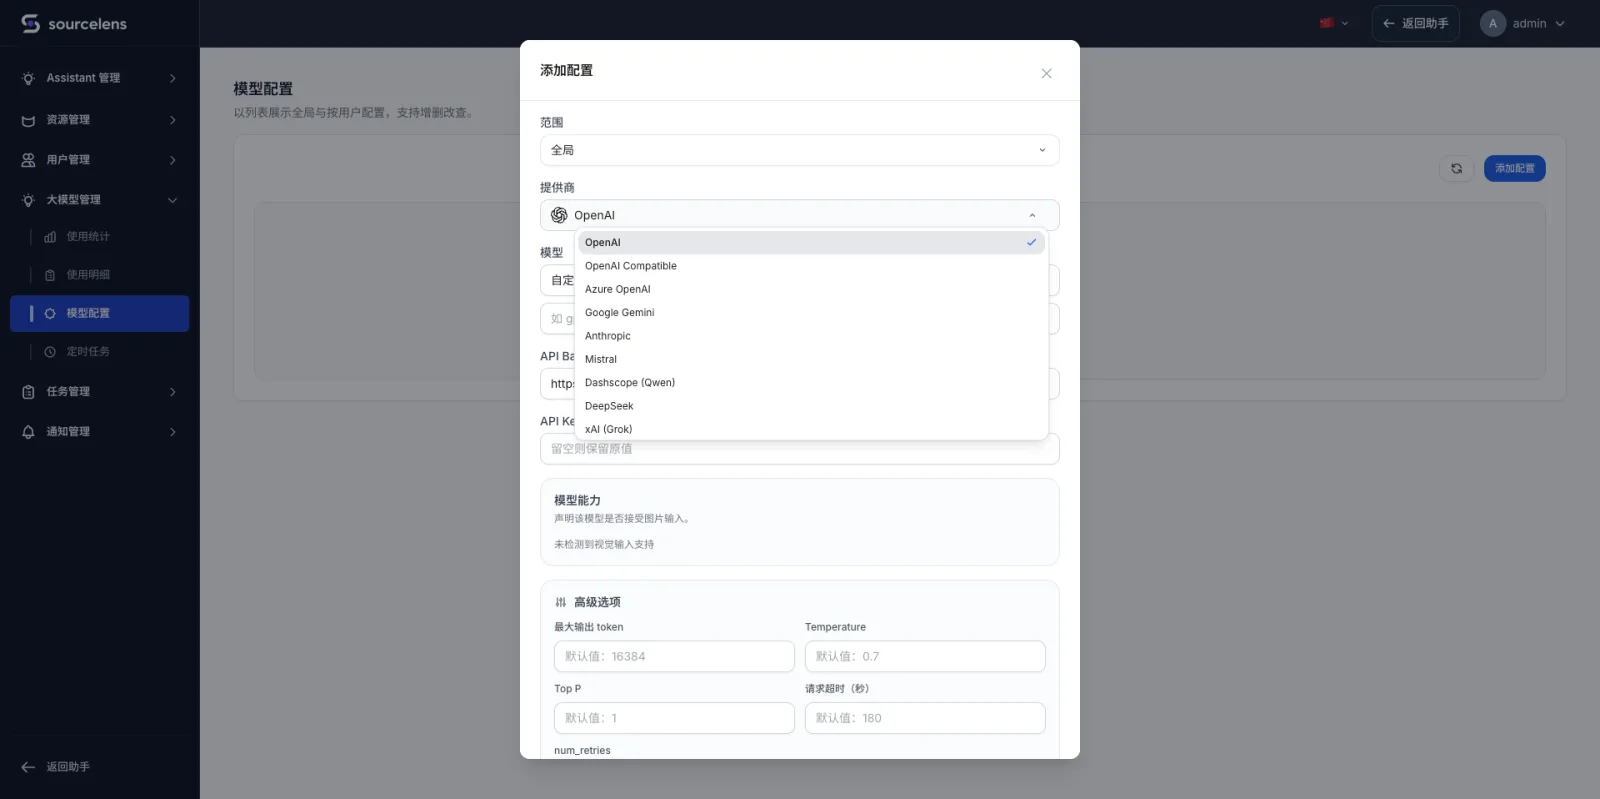
模型配置:主流供应商都在,一个界面管所有模型
第二步:上传数据并创建助手
这一步用一个具体例子走一遍:数据源是茅台官网公开的财务报告专区,从这里下载了几份年度报告 PDF,作为数据源传进 SourceLens,再完整走一遍建数据源、建助手的过程。
先建数据源:起个名字,选类型——手动上传、飞书、GitHub、GitLab 都支持,这里选手动上传,把下载好的年报 PDF 传上去,再配置同步和处理策略。用户不需要自己先研究 Chunk 怎么切,也不需要单独搭建 Vector Database;SourceLens 会在内部完成必要的解析和标准化。
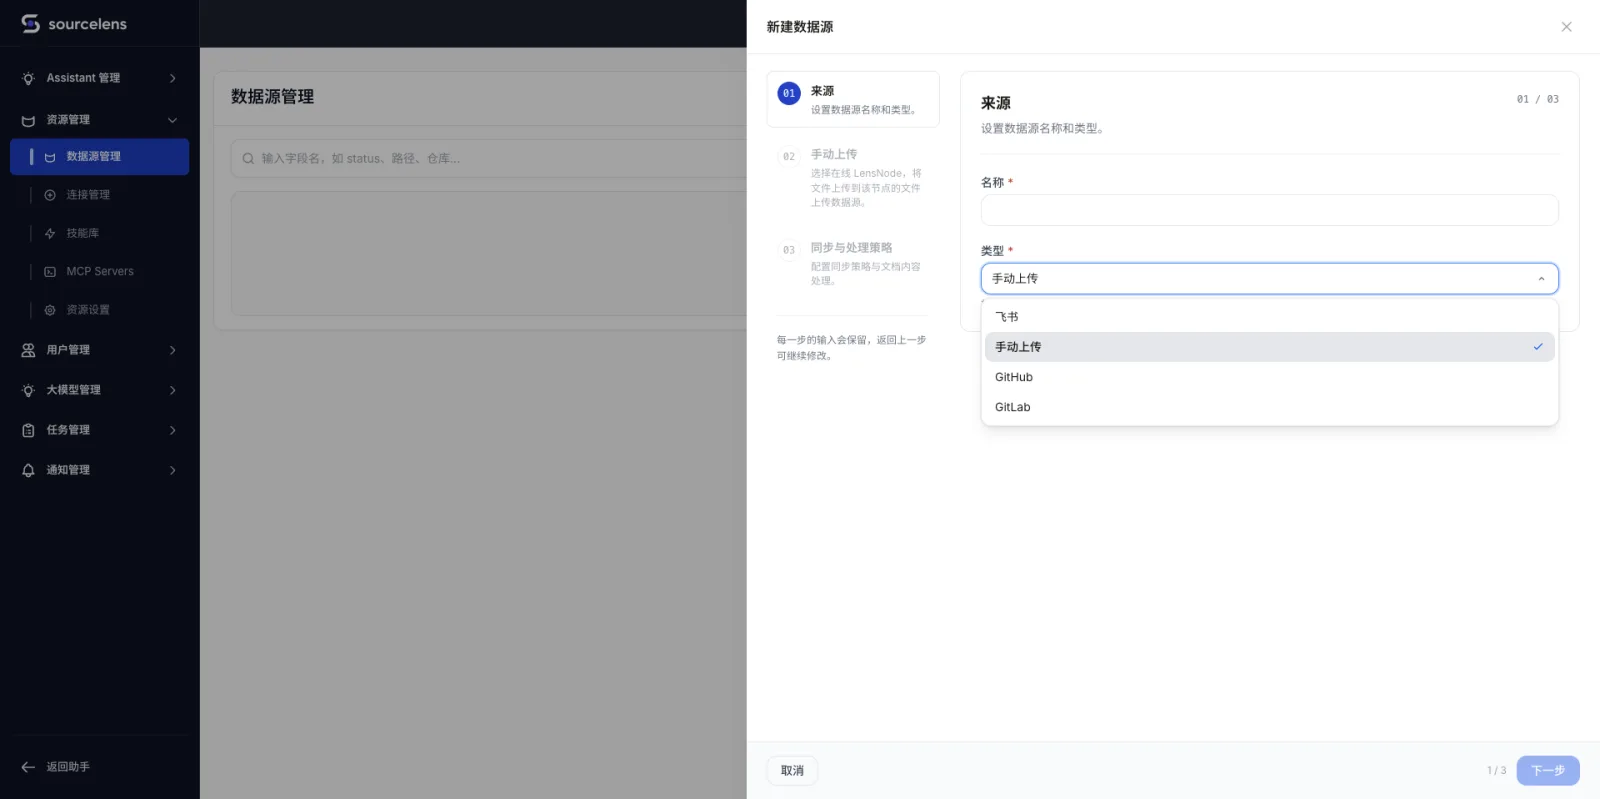
新建数据源:起名字、选类型、配同步策略
数据源建好之后,创建一个助手,一共四步。第一步定名称和 Agent 模型:
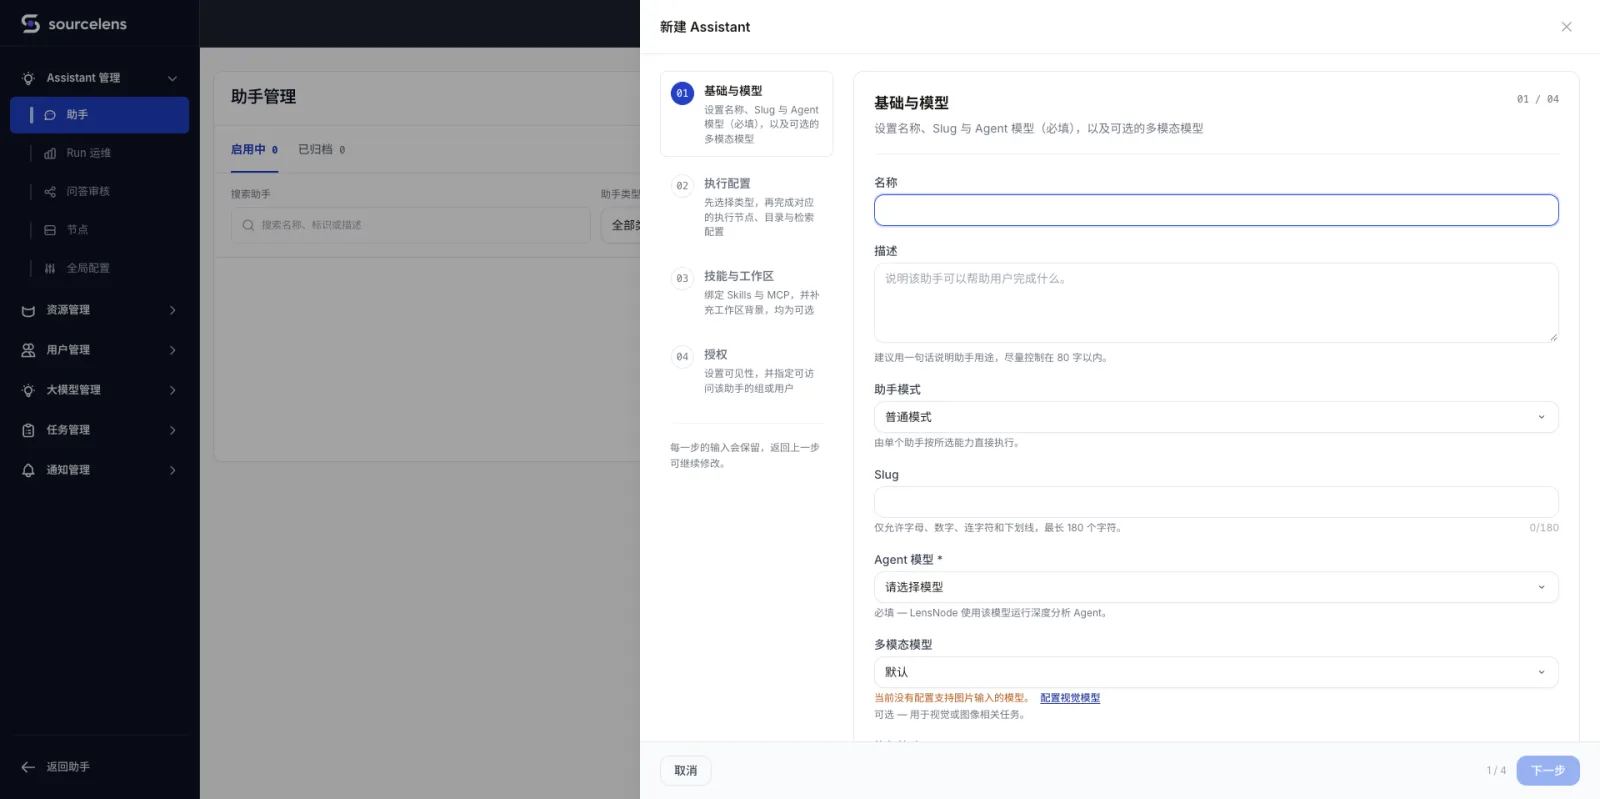
第一步:起名字,选 Agent 模型
第二步选分析类型(知识问答 / 代码分析 / 通用对话),关联刚才建好的数据源,再设置检索时要排除的目录和文件类型:
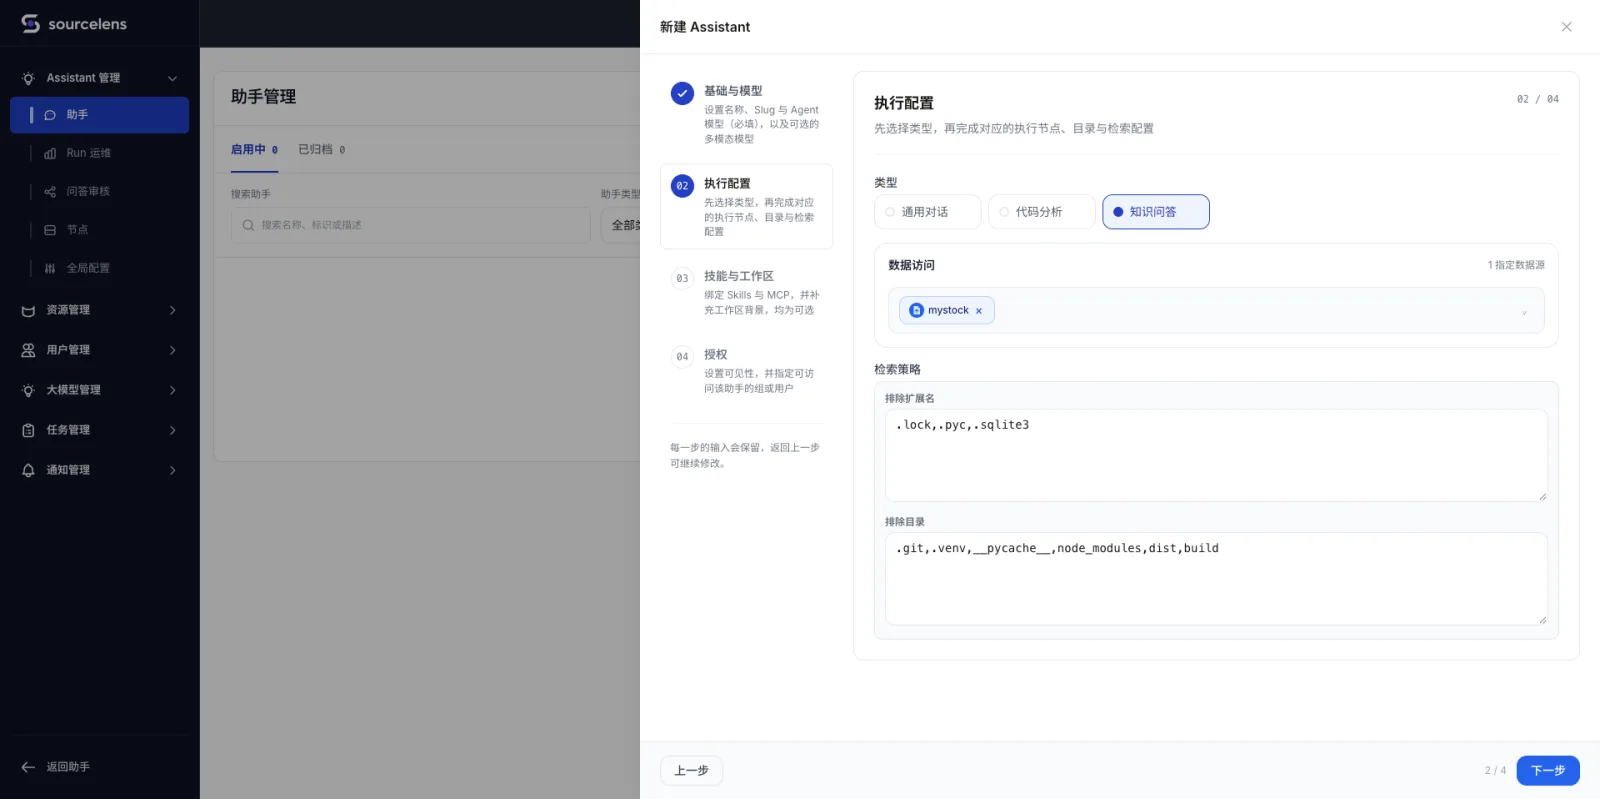
第二步:选分析类型,关联数据源,设排除规则
第三步是技能与工作区,可选:可以写一段工作区指引告诉 Agent 业务背景和检索优先级,也可以绑定内置插件、Skills、MCP Server,都不填也能往下走:
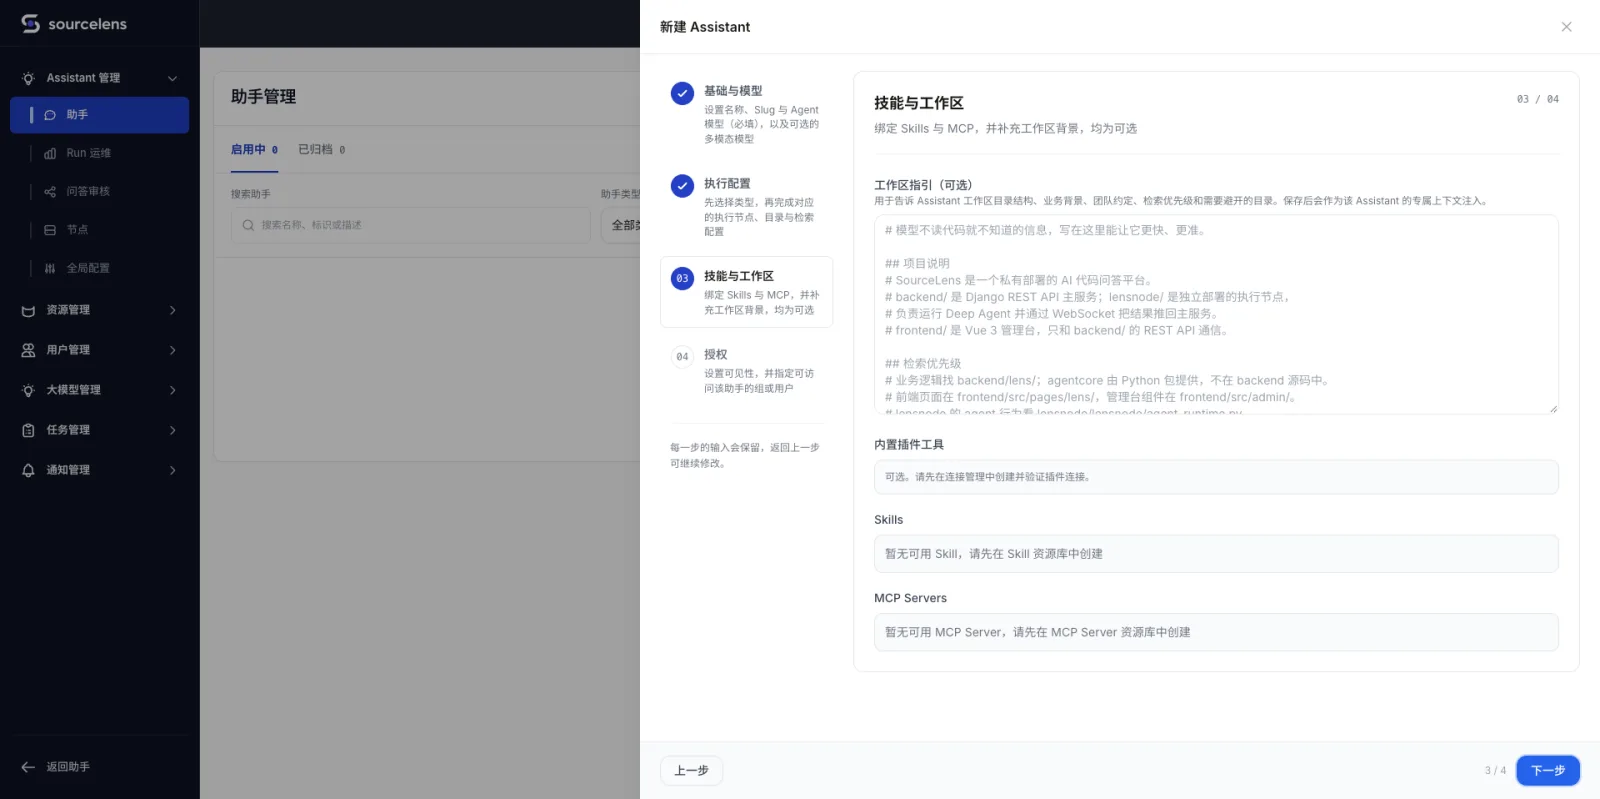
第三步:技能与工作区,全部可选
第四步设可见性,公开还是私有,管理员始终能访问全部助手;点完成创建,助手就建好了:
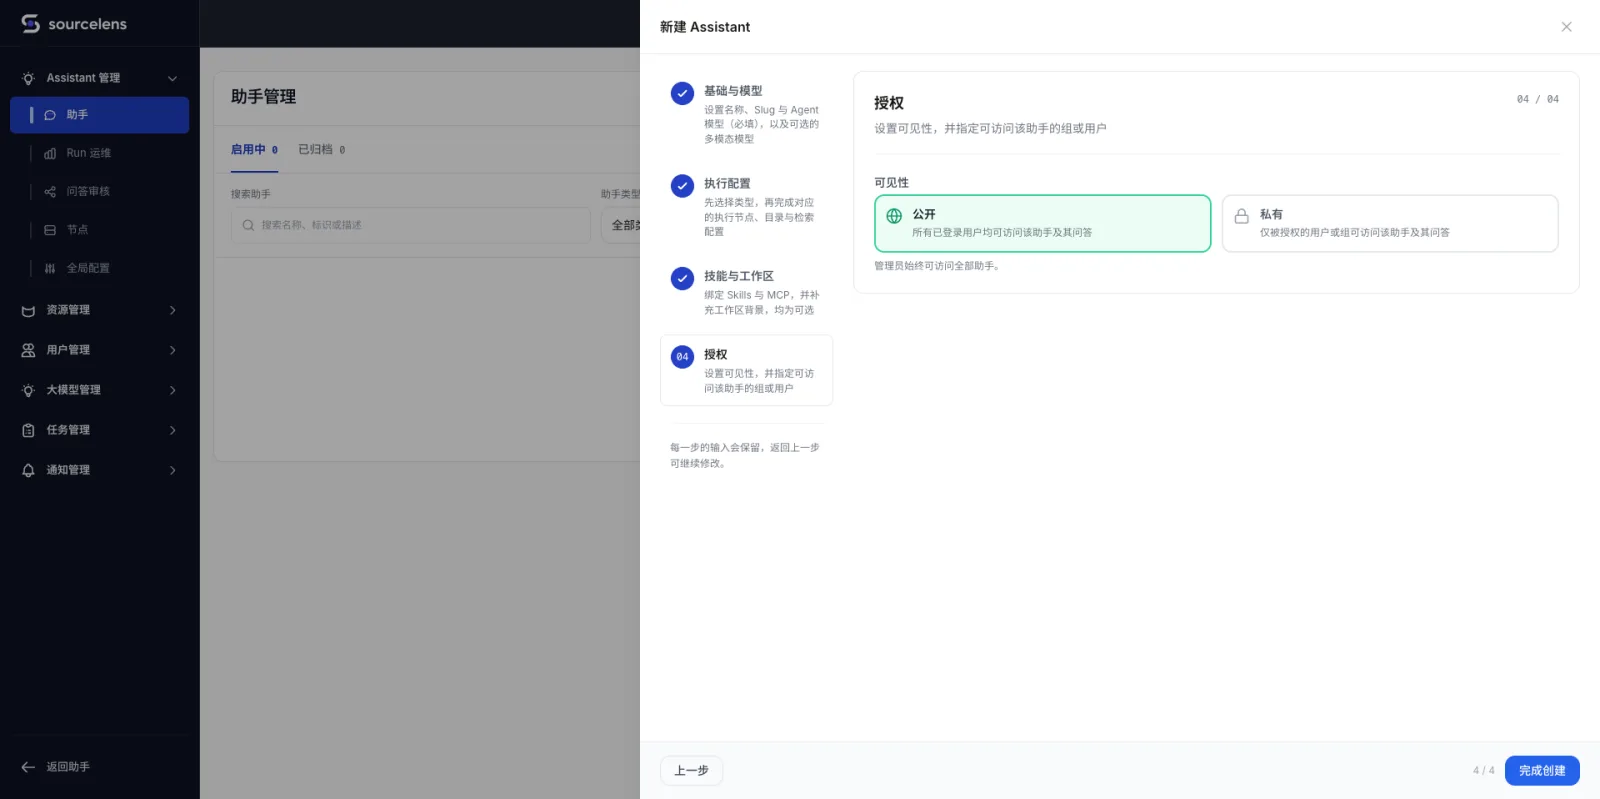
第四步:设可见性,完成创建
第三步:提问并查看回答
助手建好,进去直接问。这次问的是"贵州茅台 2021—2025 年营收情况和驱动力是什么",SourceLens 会自己去传上去的年报 PDF 里翻数据、算同比、做归因,输出一份带表格的分析:
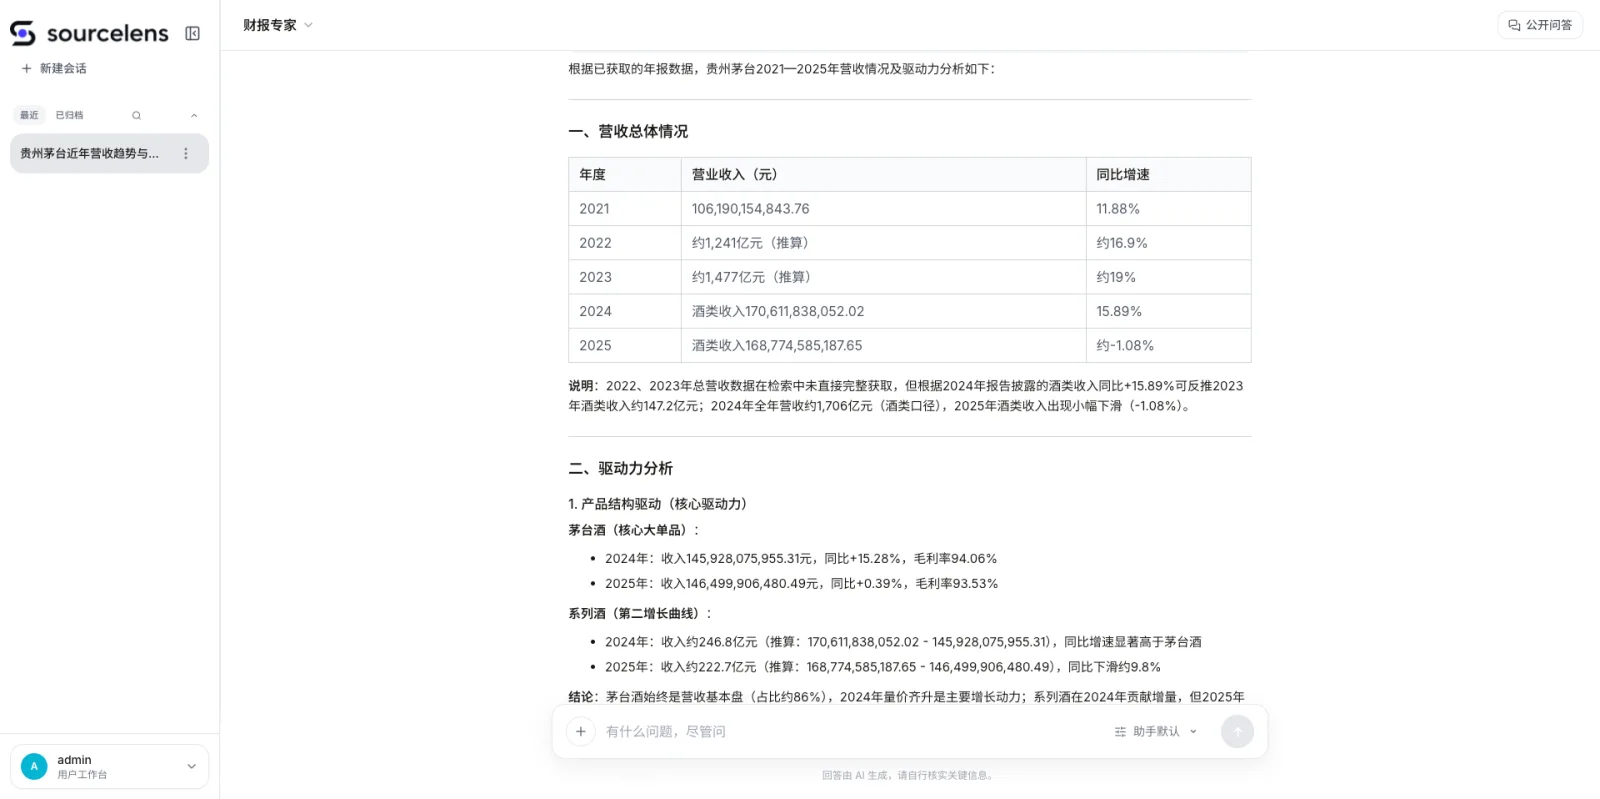
提问之后,Agent 自己去翻年报、算数据,给出结构化分析
往下翻,答案会继续给出驱动力分析——产品结构、渠道结构、价格因素、产量销量逐条拆开讲,也是直接从 PDF 里读出来再归纳的,不是模型自己编的:
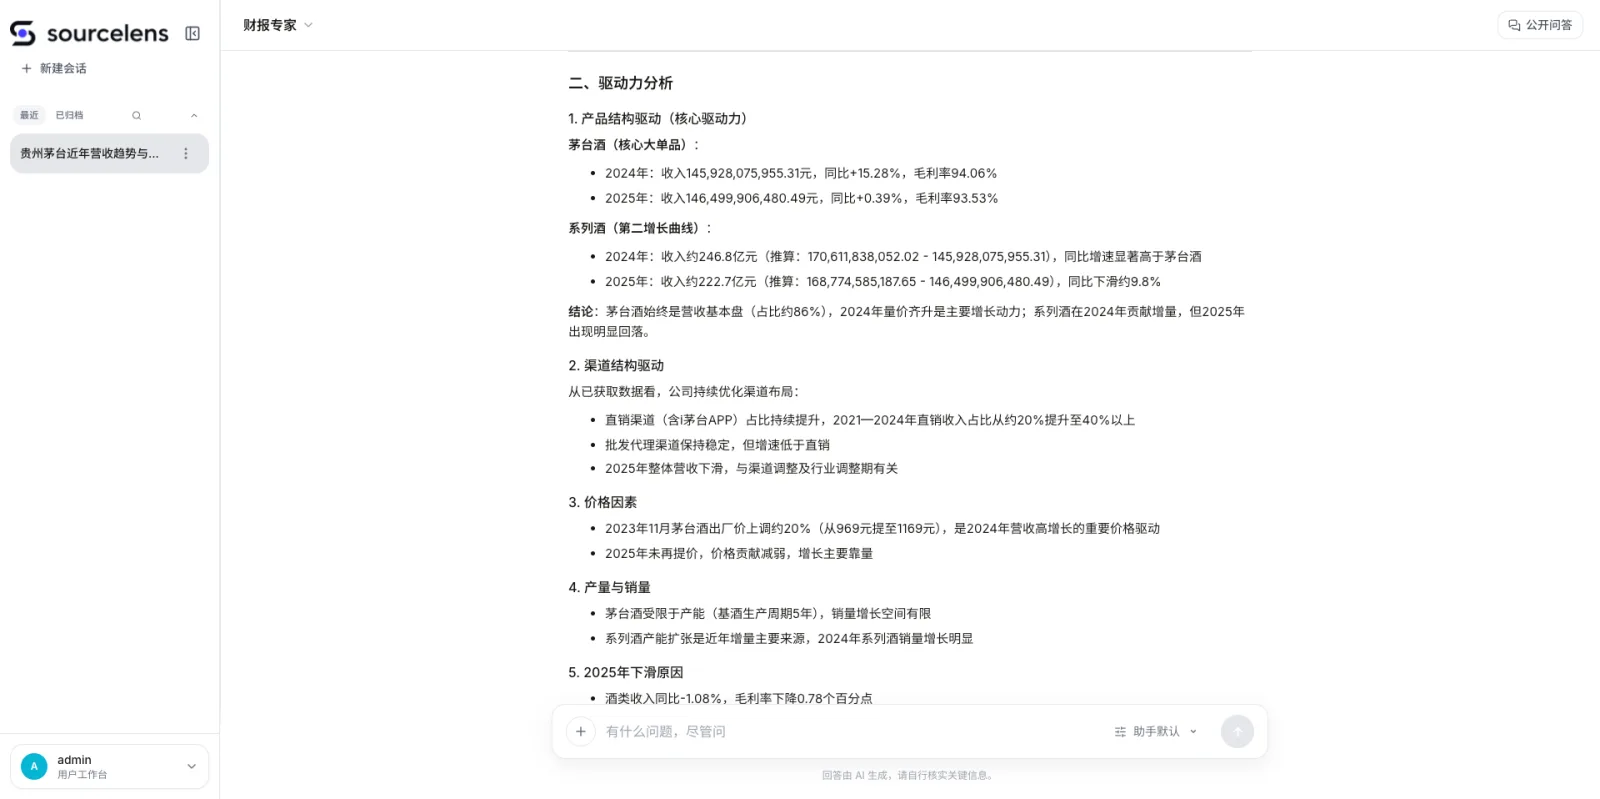
答案往下翻,是分条列出的驱动力分析
这里真正值得看的,不只是最终答案,而是答案下面折叠着的"内容依据"——具体引用了哪份 PDF 的哪几页,点开就能跳过去核对。
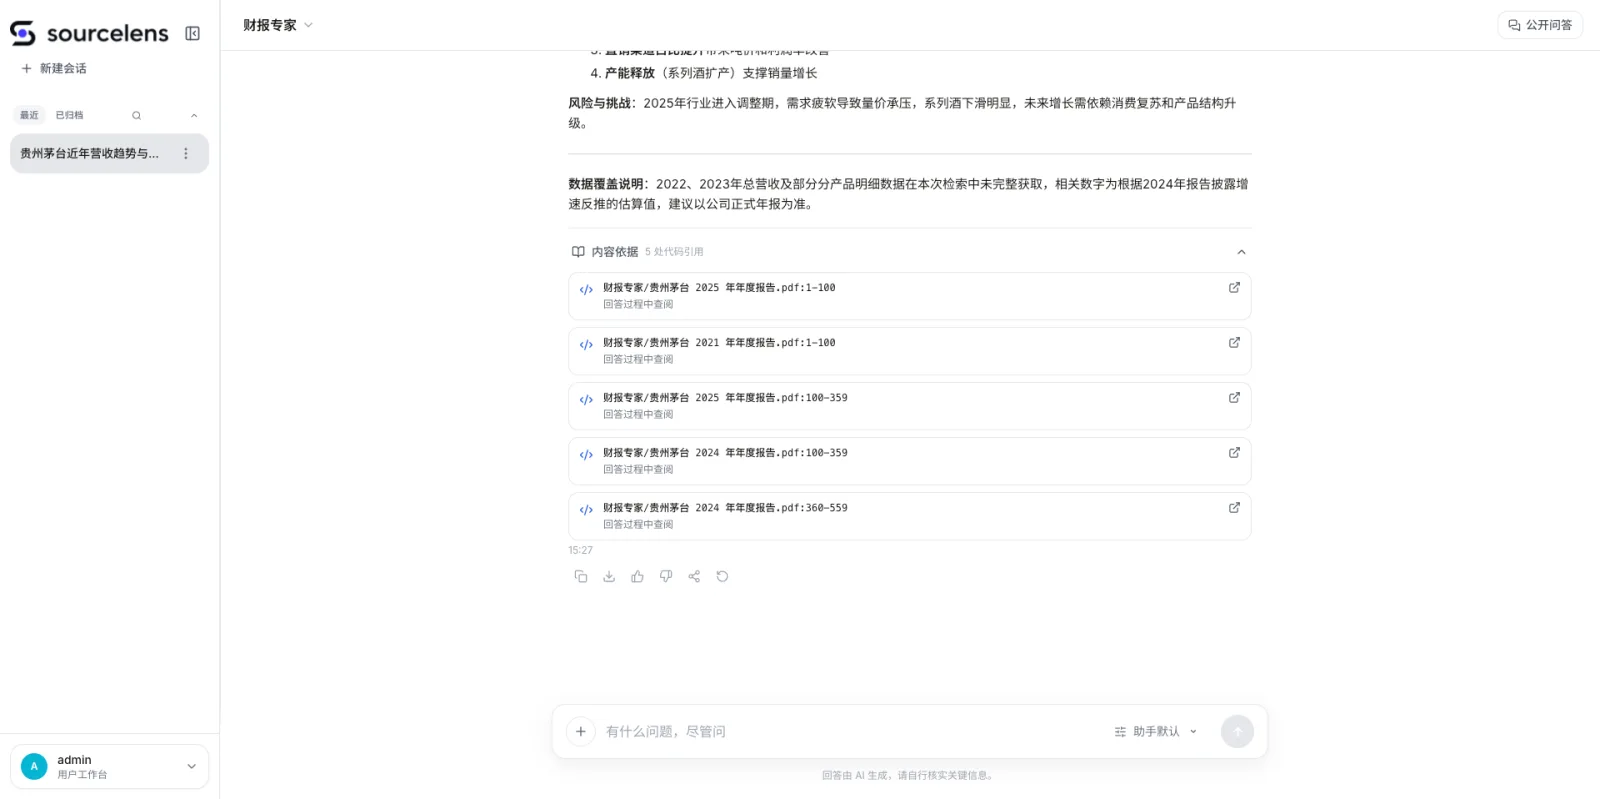
答案下面挂着具体引用了哪份文件、哪几页,点开就能核对
整个过程就是:安装并配置模型 → 上传数据并创建助手 → 提问并查看证据。
我们真正相信的,是 Harness Agent 这条路
做 SourceLens 这一路,我们越来越相信,Harness Agent 会成为一种通用的 AI 工作模式:系统设计的重点,正从"少调用一次模型",转向"给 Agent 足够完整的 Context、工具和行动空间,让它把问题真正做对"。Codex、Work Buddy 已经证明这套模式能跑通,但它们解决的是个人的问题;SourceLens 要解决的是企业的问题。经常有人问这两者的区别,具体到落地上大概是这样:
| Codex / Work Buddy | SourceLens | |
|---|---|---|
| 面对的数据 | 一个人本地的文件 | 一家公司共享的数据 |
| 怎么用起来 | 每个人自己装运行环境、配模型 | 管理员配置一次,其他人打开链接就能用 |
| 治理 | 个人工具,用不上 | 按助手划分数据来源、做权限控制,答案可追溯 |
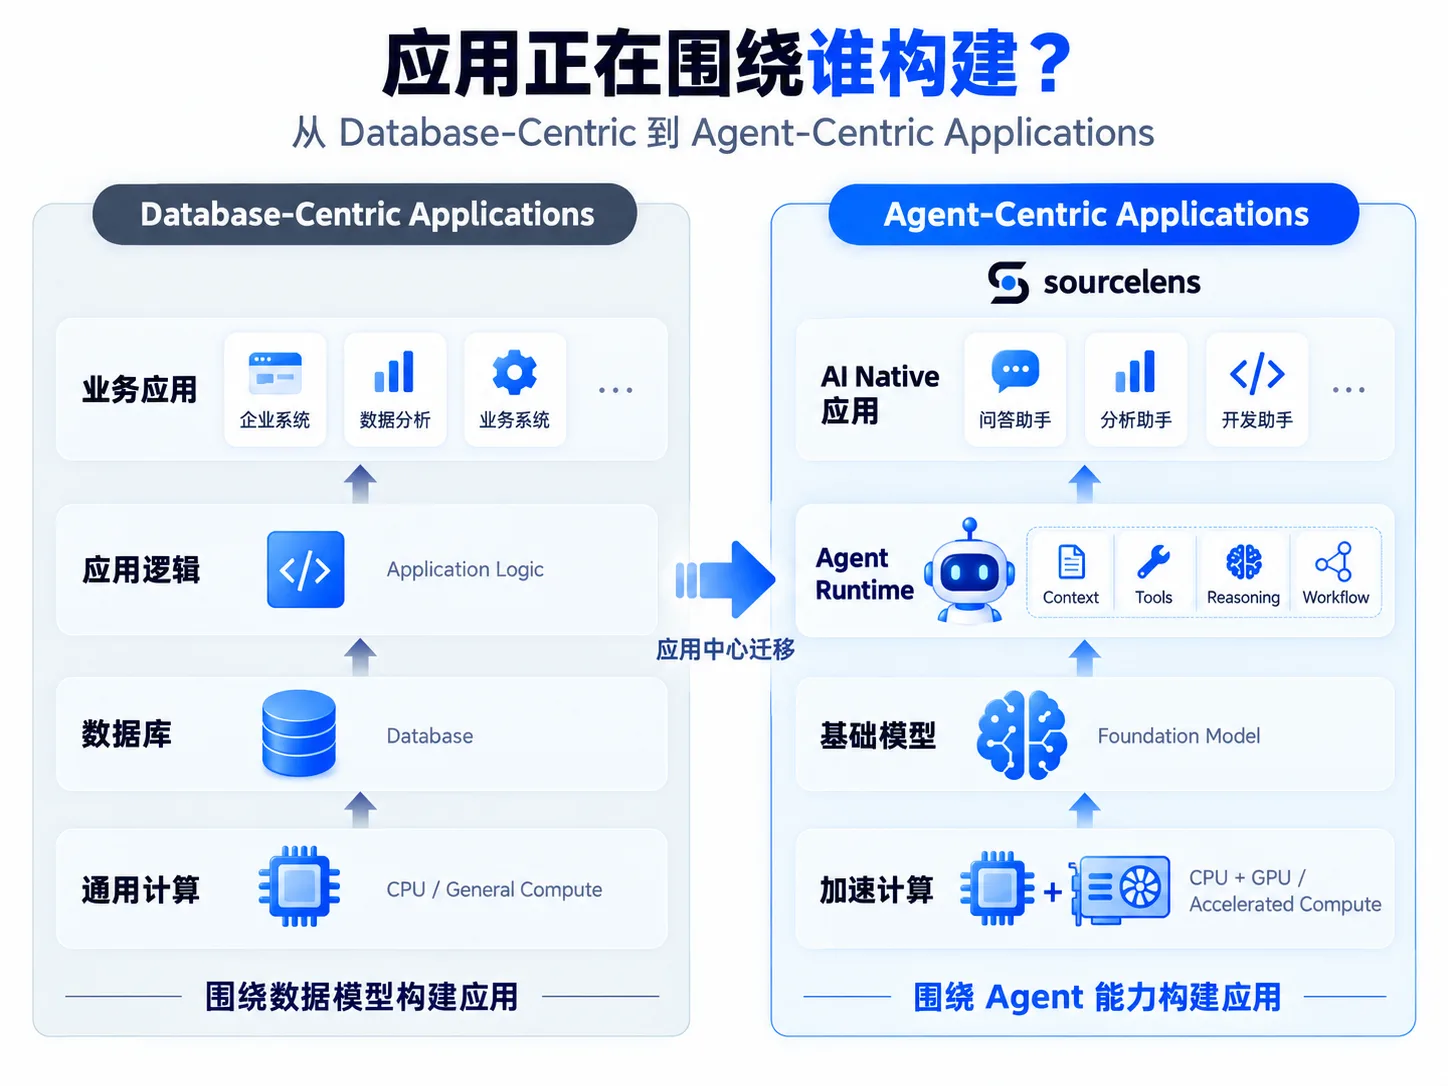
数据库时代围绕数据模型构建应用;AI 时代围绕 Agent 能力构建应用
另外一个我们越来越明确的判断是:如果过去几十年是数据库的时代,那么 AI 之后,会是非结构化数据真正被重新发现的时代。Word、PPT、PDF、邮件、会议纪要、图片和代码,过去只是被存储和搜索,AI 第一次让机器能直接阅读、关联、推理这些数据。我们也不急着先把数据整理成一套完美的 Ontology——更有效的方式是先让 Agent 进入真实数据,Search、Read、Reason,再决定哪些值得沉淀。数据库时代,人先把世界结构化,再让机器计算;AI 时代,机器开始可以直接从非结构化数据中寻找关系、建立 Context,并形成知识。