Cómo construir una base de conocimiento empresarial de IA directamente desde documentos de Office
A las empresas nunca les faltan documentos. Lo que les falta es una forma de que la IA realmente entienda los documentos que ya tienen. Manuales de producto, planes de proyecto, FAQs, registros de entrega — todo eso ya existe. Pero en el momento en que intentas que la IA responda con precisión una pregunta de negocio real, acabas otra vez en trocear, vectorizar y montar una base de datos vectorial.
SourceLens es un proyecto de código abierto que se salta la base de datos vectorial y convierte los documentos empresariales directamente en una base de conocimiento consultable. Nació para resolver un problema muy concreto: ¿cómo logra la IA responder con precisión preguntas reales sobre productos y proyectos dentro de una empresa?
Tomemos HyperBDR como ejemplo. Preventa, entrega y soporte se topan cada día con el mismo tipo de preguntas: si una versión de Linux es compatible, si una migración de VMware a la nube destino debería usar modo Agent o Agentless, si una limitación viene del producto en sí o de la configuración del proyecto. Las respuestas casi siempre ya existen — solo están dispersas entre documentación de producto, wikis, presentaciones, archivos de Word, PDFs, FAQs, material de proyecto, notas de reuniones y, a veces, hasta en el propio código.
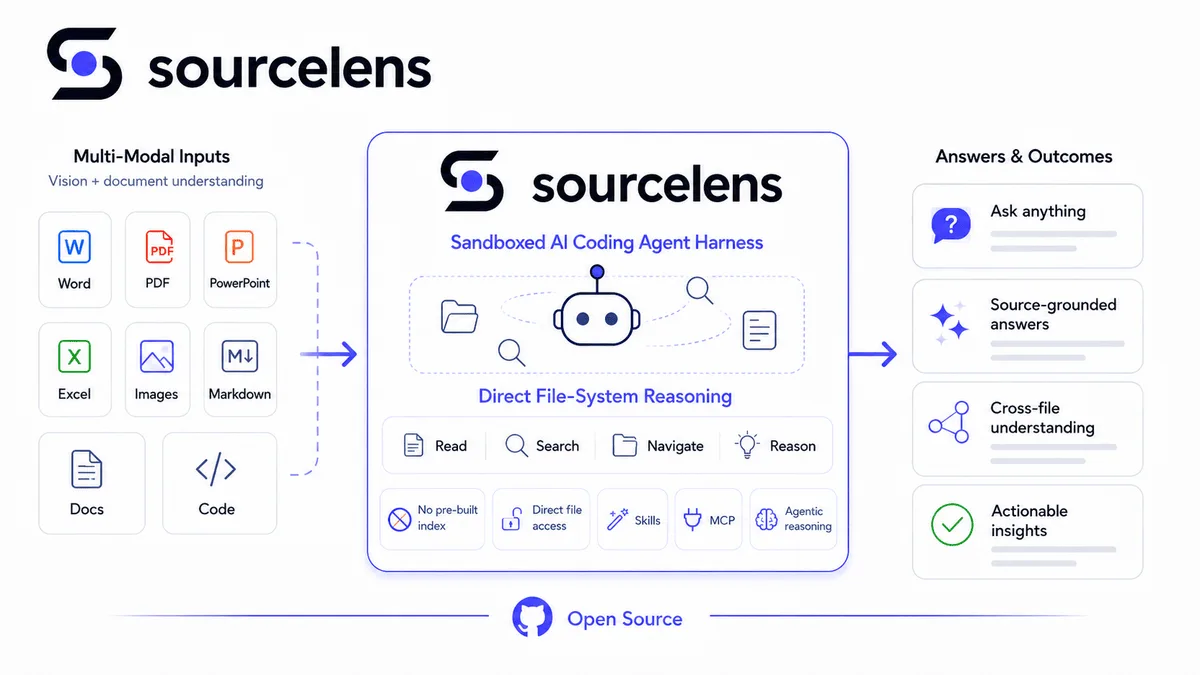
SourceLens en una sola imagen: sin trocear ni indexar a mano — el preprocesamiento ocurre internamente y el agente entra directo al contenido resultante a buscar, leer y razonar
Para un ingeniero con años de experiencia, la mayoría de estas preguntas no son realmente difíciles — sabe dónde buscar y qué documentos hay que cruzar. Pero esa capacidad vive en la experiencia personal acumulada. Alguien recién llegado no puede construir ese mismo mapa mental de la noche a la mañana, y el producto, las versiones y el historial de proyectos siguen cambiando todo el tiempo, así que la capacitación y el boca a boca nunca terminan de alcanzar. Lo que en realidad queríamos resolver era cómo convertir ese tipo de conocimiento tácito e individual en algo que toda la empresa pudiera simplemente usar.
Nuestro enfoque ahora es directo: sincronizar todo ese material en SourceLens, montar un asistente acotado a un área de negocio específica, y dejar que la gente le pregunte directamente. Algo como “¿HyperBDR soporta Ubuntu 24.04?” o “El cliente tiene un entorno mixto de VMware 7, Windows y Linux y quiere migrar a la nube destino — ¿qué enfoque deberíamos usar y cuáles son los límites?”. SourceLens busca el material relevante por su cuenta, lee el contexto, sigue el hilo, y solo entonces da una conclusión respaldada por la evidencia que realmente encontró — razonada, no improvisada.
Lo que importa aquí no es si la IA puede responder, sino si la respuesta está respaldada por algo. En un contexto empresarial, queremos que el sistema diga explícitamente en qué material se apoyó y por qué llegó a esa conclusión, y que si no hay evidencia suficiente, simplemente lo diga en vez de recurrir al conocimiento general del modelo.
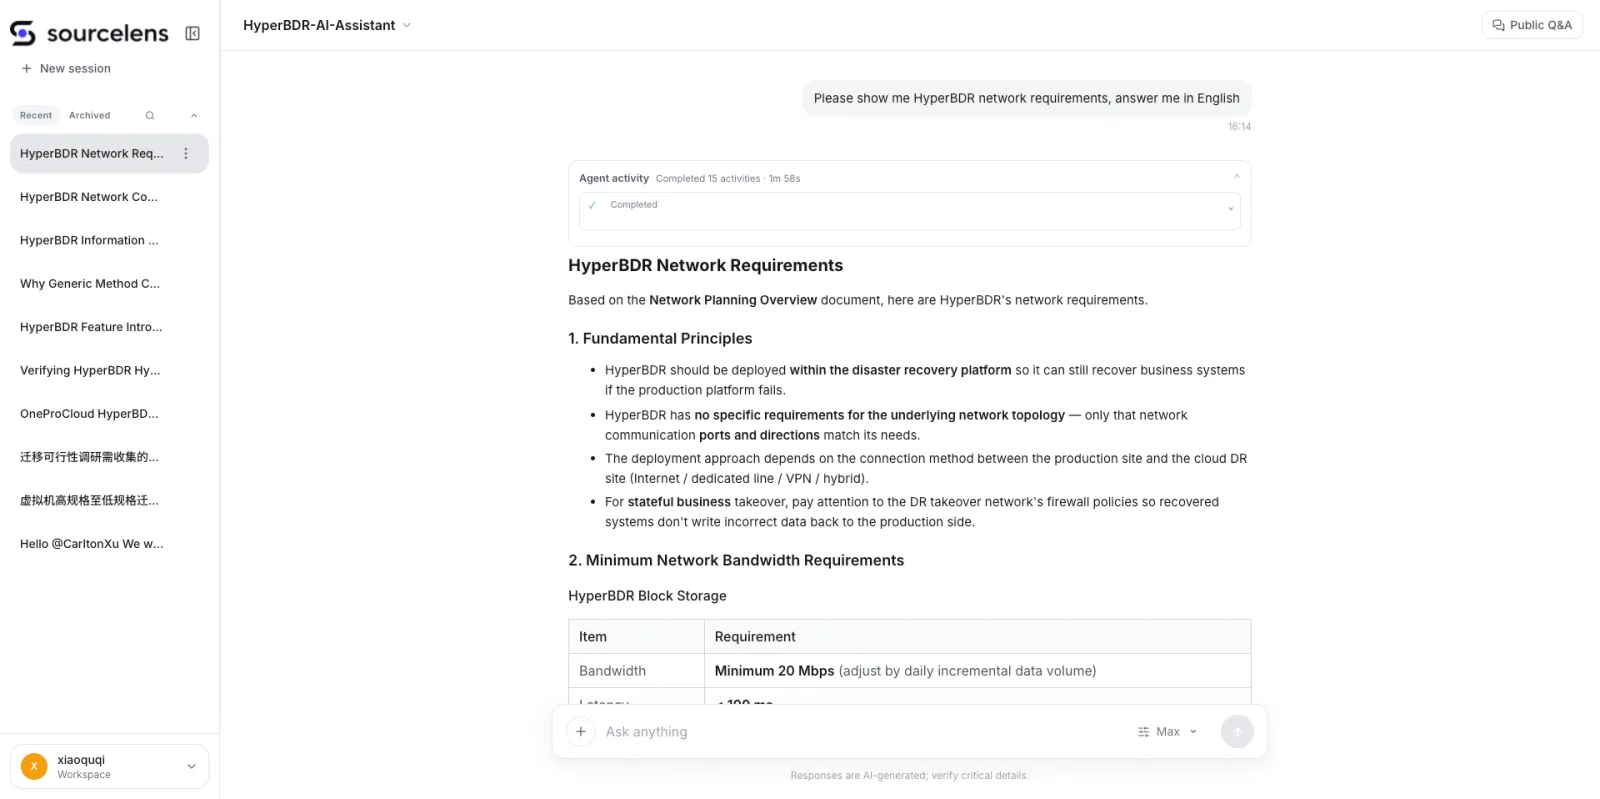
Pregunta en inglés, respuesta en inglés
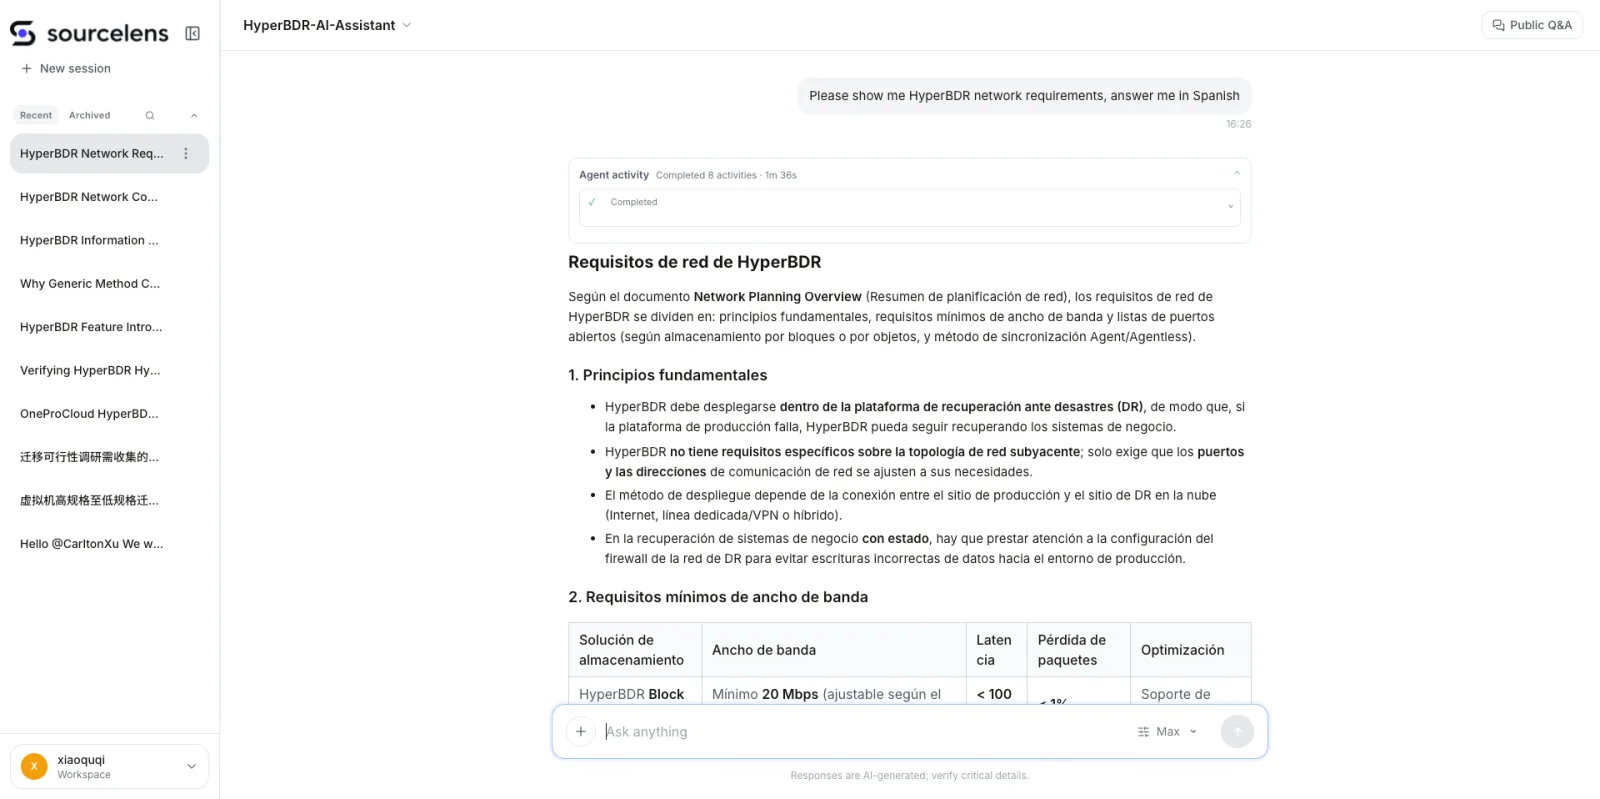
Pregunta en inglés, indicando responder en español
Del RAG tradicional a SourceLens: por qué elegimos un camino distinto
Cuando construimos por primera vez un sistema de preguntas y respuestas empresarial, tomamos el mismo camino que todo el mundo en ese momento: RAG. En la superficie no parece complicado — arrastras un par de bloques para armar un flujo, conectas una base de conocimiento a un modelo grande, y en poco tiempo ya está funcionando. Pero una vez que de verdad lo has hecho, te das cuenta de que lo difícil nunca fue el flujo posterior. Es el paso anterior: convertir documentos empresariales sin procesar en una base de conocimiento vectorial que de verdad sirva.
Ya había bastantes herramientas de RAG en el mercado, pero la mayoría resolvía la orquestación del flujo, no el problema real — cómo analizar, trocear y organizar documentos empresariales desde el principio. Los PDFs, los archivos de Word y las presentaciones tienen estructuras muy distintas entre sí, y un solo documento puede mezclar títulos, tablas, imágenes y párrafos largos. Si troceas demasiado fino, pierdes contexto; si troceas demasiado grueso, la recuperación se vuelve imprecisa. Terminamos escribiendo nuestros propios scripts externos para analizar, limpiar y trocear cada tipo de documento, y luego pasamos rondas y rondas ajustando embeddings y estrategia de recuperación.
En nuestra propia implementación interna, pasaron alrededor de cuatro meses entre la investigación y el lanzamiento, y al menos tres de esos meses se fueron solo en experimentar con “cómo trocear esto”. Documentos distintos necesitaban estrategias distintas, y reformular la misma pregunta con un troceo diferente podía cambiar por completo lo que se recuperaba. Después de mucho probar, llevamos la precisión de algunos casos internos hasta un 80% aproximadamente. Así que cuando decimos que repensamos el RAG, no es porque lo abandonáramos a medio camino — es precisamente porque lo llevamos hasta producción que vimos su costo de ingeniería real y sus límites.
A medida que avanzábamos, nos topamos con un problema más profundo: incluso con un troceo y una recuperación decentes, las preguntas complejas seguían sin poder responderse de forma confiable. Muchas preguntas empresariales no tienen su respuesta completa dentro de un solo fragmento — está repartida entre distintos documentos, distintas secciones, a veces distintos tipos de datos por completo. La IA necesita entender la pregunta, encontrar la primera pista, seguir sumando contexto, y finalmente combinar varias piezas de información en un juicio. En ese punto, el problema ya no es realmente recuperación. Se parece más a investigación y razonamiento.
Lo que de verdad nos hizo pensar fue Cursor. Lo que más nos llamó la atención al usar Cursor para problemas de código no fue la técnica de indexado que tenía debajo, sino la forma en que trabajaba: el agente entiende la pregunta primero, luego busca palabras clave, abre los archivos relevantes, lee el contexto alrededor, y sigue buscando según lo que acaba de encontrar. Todo el ciclo es en realidad bastante simple — en el fondo es solo Buscar, Leer, Razonar, y volver a Buscar.
Eso nos llevó a hacernos otra pregunta: si Cursor puede leer así un repositorio de código complejo, ¿por qué el mismo enfoque no podría funcionar con documentos empresariales?
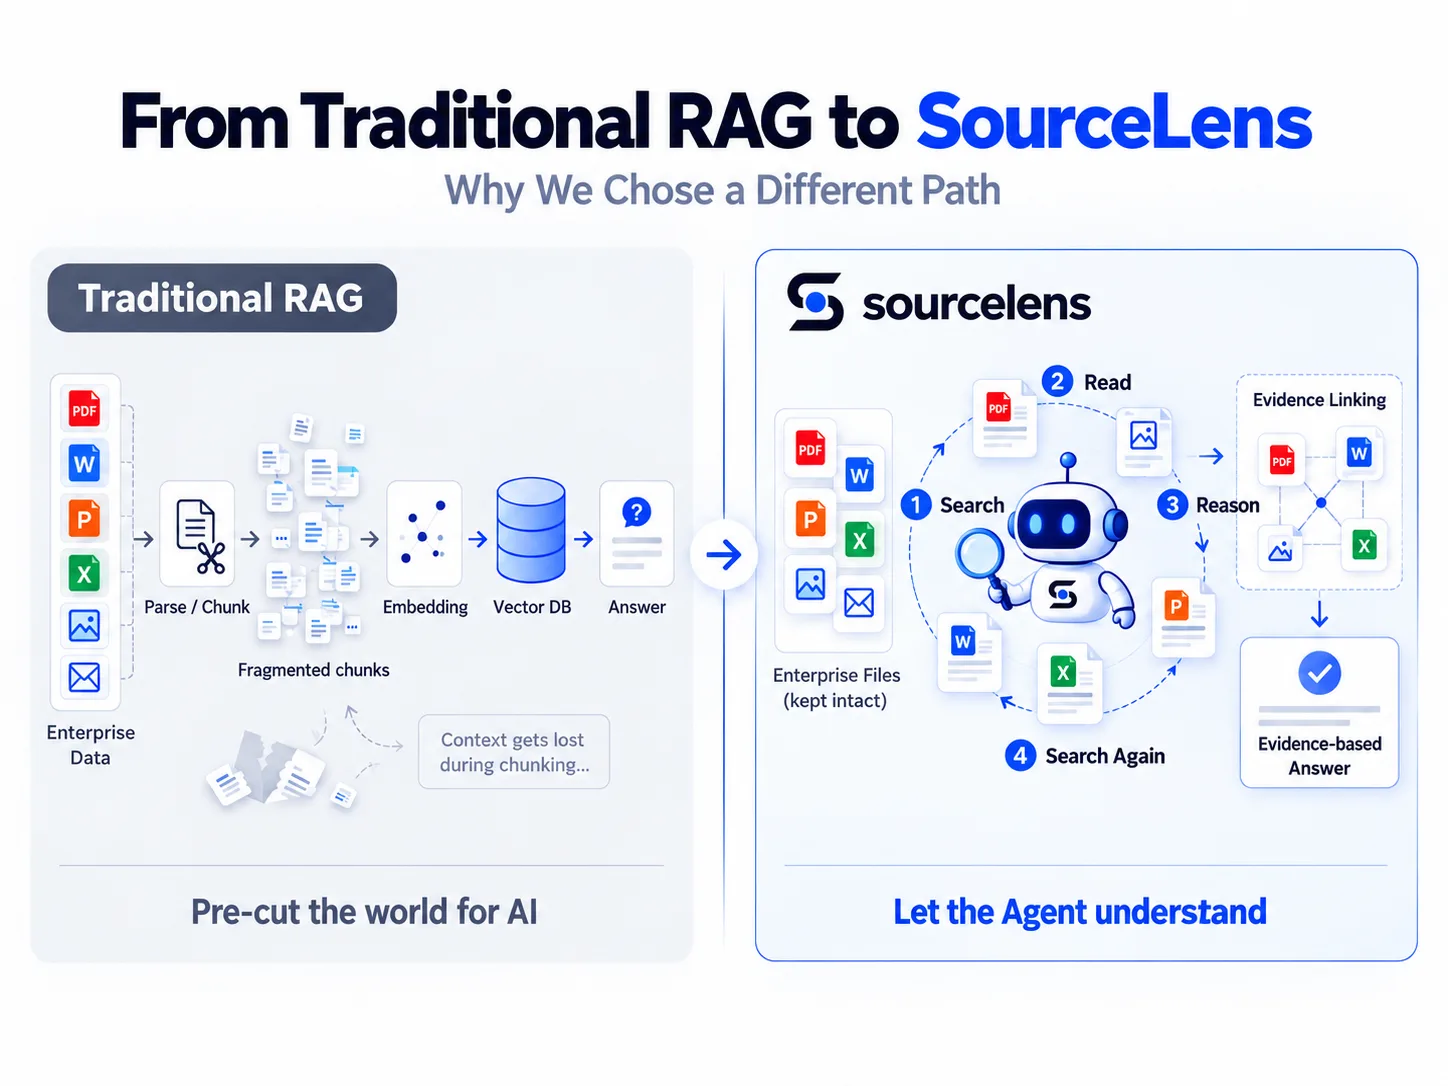
El RAG tradicional recorta el mundo de antemano para la IA; SourceLens deja que el agente lo entienda directamente
Fue entonces cuando empezamos a diseñar SourceLens. El propio nombre resume la idea central: obtener perspectiva (Lens) directamente desde la fuente (Source). En lugar de reorganizar todo el material empresarial en otra estructura de conocimiento más para que la IA la consulte, mantenemos los datos originales y su contexto lo más intactos posible, y dejamos que el agente entre directo a los datos a buscar, leer, conectar y razonar.
Eso también fue lo que llevó el diseño de SourceLens en una dirección distinta a la del RAG tradicional. Dejamos de tratar la recuperación vectorial como la única puerta de entrada para entender documentos empresariales, y pusimos el harness / motor del agente en el centro. El agente decide por sí mismo qué necesita consultar según la pregunta, busca el material relevante, lee el contexto, sigue nuevas pistas, y finalmente forma una respuesta respaldada por evidencia.
Aun así, sigue habiendo una diferencia real entre los documentos empresariales y el código. El código es, por naturaleza, fácil de leer y buscar para un agente como texto plano; los datos empresariales, en cambio, viven sobre todo en PowerPoint, Word, PDF, Excel, imágenes, escaneos, correos y todo tipo de adjuntos, y buena parte de la información importante existe solo dentro de una imagen. Por eso SourceLens no le pide al usuario trocear, vectorizar ni construir un índice de antemano — pero internamente sí hace el análisis y la normalización necesarios, convirtiendo estos formatos desordenados en contexto de datos que un agente sí puede buscar, leer y razonar.
Que es también la forma más directa en que hemos llegado a entender esto: buena parte del trabajo de ingeniería en el RAG tradicional consiste en decidir, de antemano, cómo debe trocearse e indexarse los datos para la IA. SourceLens prefiere devolverle ese criterio al agente, y dejar que decida qué buscar a continuación según la pregunta real que tiene enfrente.
Lo que terminó teniendo SourceLens es un flujo simple: Datos → Preprocesamiento / Gobernanza → Contexto → Harness Engine → Skills → Asistente. El harness engine y el modelo subyacente pueden seguir cambiando; lo que una empresa realmente necesita acumular a largo plazo es su propia data, sus permisos, sus skills, sus workflows y su evidencia.
Primeros pasos
Usar SourceLens en la práctica se reduce a tres pasos: instalar y configurar un modelo, subir datos y crear un asistente, hacer una pregunta y revisar la respuesta — que es exactamente como está diseñada la propia página de bienvenida de SourceLens. Para hacerlo concreto, vamos a recorrer los tres pasos con un ejemplo real: los PDFs trimestrales para accionistas de Tesla como fuente de datos, y una pregunta de análisis financiero que obliga al asistente a cruzar todos esos documentos a la vez.
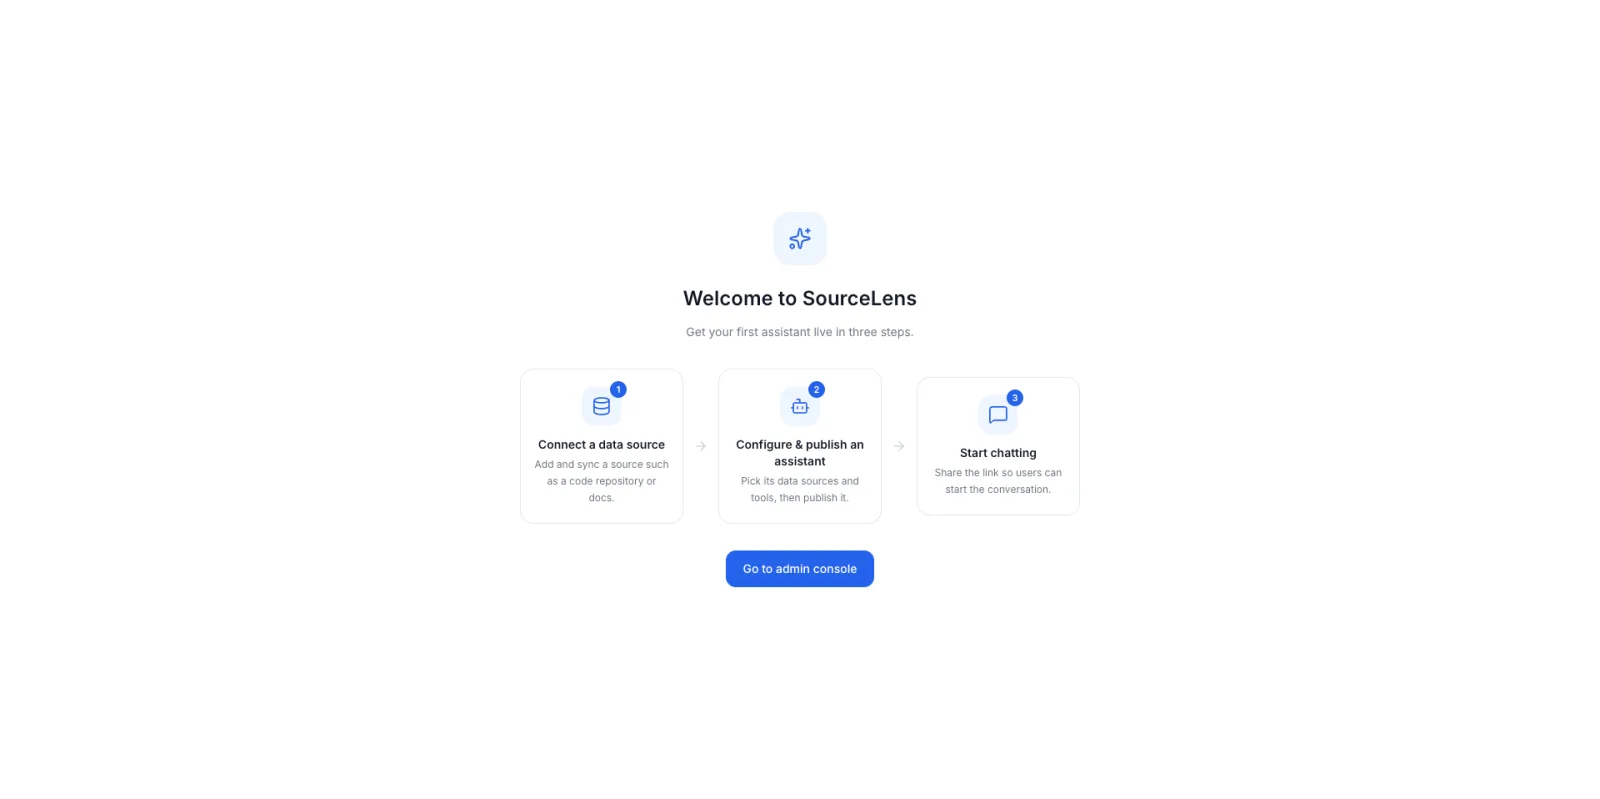
Lo que ves al iniciar sesión por primera vez: tres pasos para tu primer asistente
Paso 1: instalar y configurar el modelo
Hace falta una máquina con 4 núcleos de CPU, 8 GB de RAM y 100 GB de disco (sirve Linux, macOS o Windows con Docker Desktop), con Docker Compose V2 ya instalado.
curl -fsSL \
  https://raw.githubusercontent.com/oneprolabs/sourcelens/main/install.sh \
  | sudo bash
Si estás en China continental y GitHub va lento, usa en su lugar el espejo de Gitee:
curl -fsSL \
  https://gitee.com/oneprolabs/sourcelens/raw/main/install.sh \
  | sudo bash -s -- --channel cn --download-source gitee
Cuando termine, confirma que el servicio ya está arriba:
curl -f http://<host>:10083/healthAbre http://<host>:10083 en el navegador, inicia sesión como admin con la contraseña que está en install-info.env dentro del directorio de instalación, y ve directo a la configuración del modelo — aquí necesitas dos API keys: un modelo para chat y recuperación (DeepSeek, por ejemplo), y otro para entradas visuales, como reconocer imágenes.
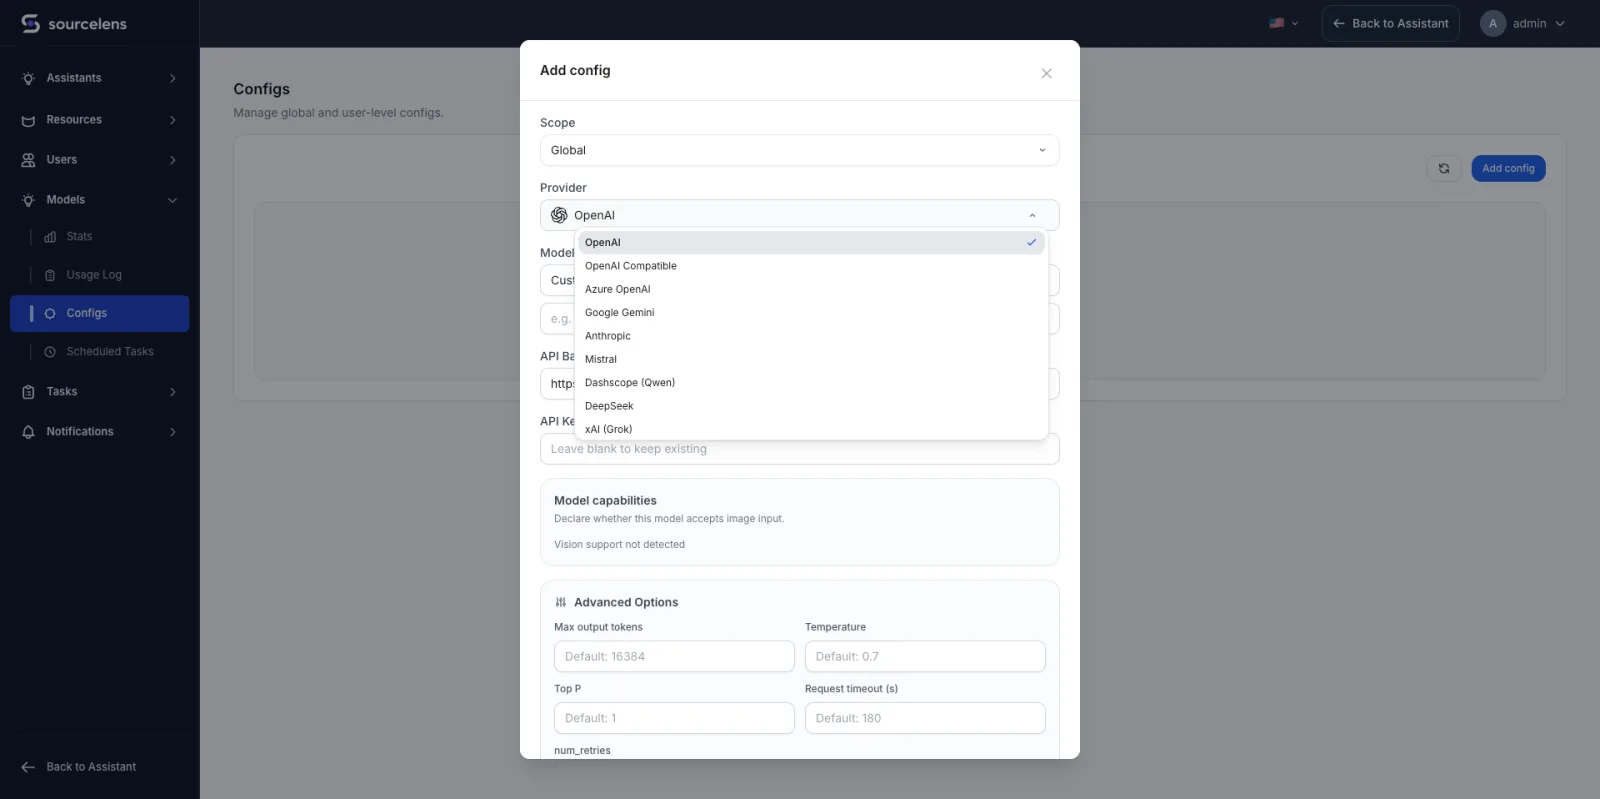
Configuración de modelo: todos los proveedores principales están aquí, todo desde una sola pantalla
Paso 2: subir datos y crear un asistente
Este paso recorre un ejemplo concreto: la fuente de datos son los propios PDFs trimestrales para accionistas de Tesla, descargados de la sección de divulgaciones trimestrales del sitio de relación con inversionistas de Tesla, subidos a SourceLens como fuente de datos, y llevados hasta el final del proceso de crear y configurar un asistente.
Empieza por la fuente de datos: ponle un nombre, elige un tipo — se admite carga manual, Feishu, GitHub y GitLab — aquí elegimos carga manual y subimos los PDFs trimestrales, luego configuramos la política de sincronización y procesamiento. No necesitas resolver tú mismo cómo trocear nada, ni necesitas montar una base de datos vectorial aparte; SourceLens se encarga internamente del análisis y la normalización necesarios.
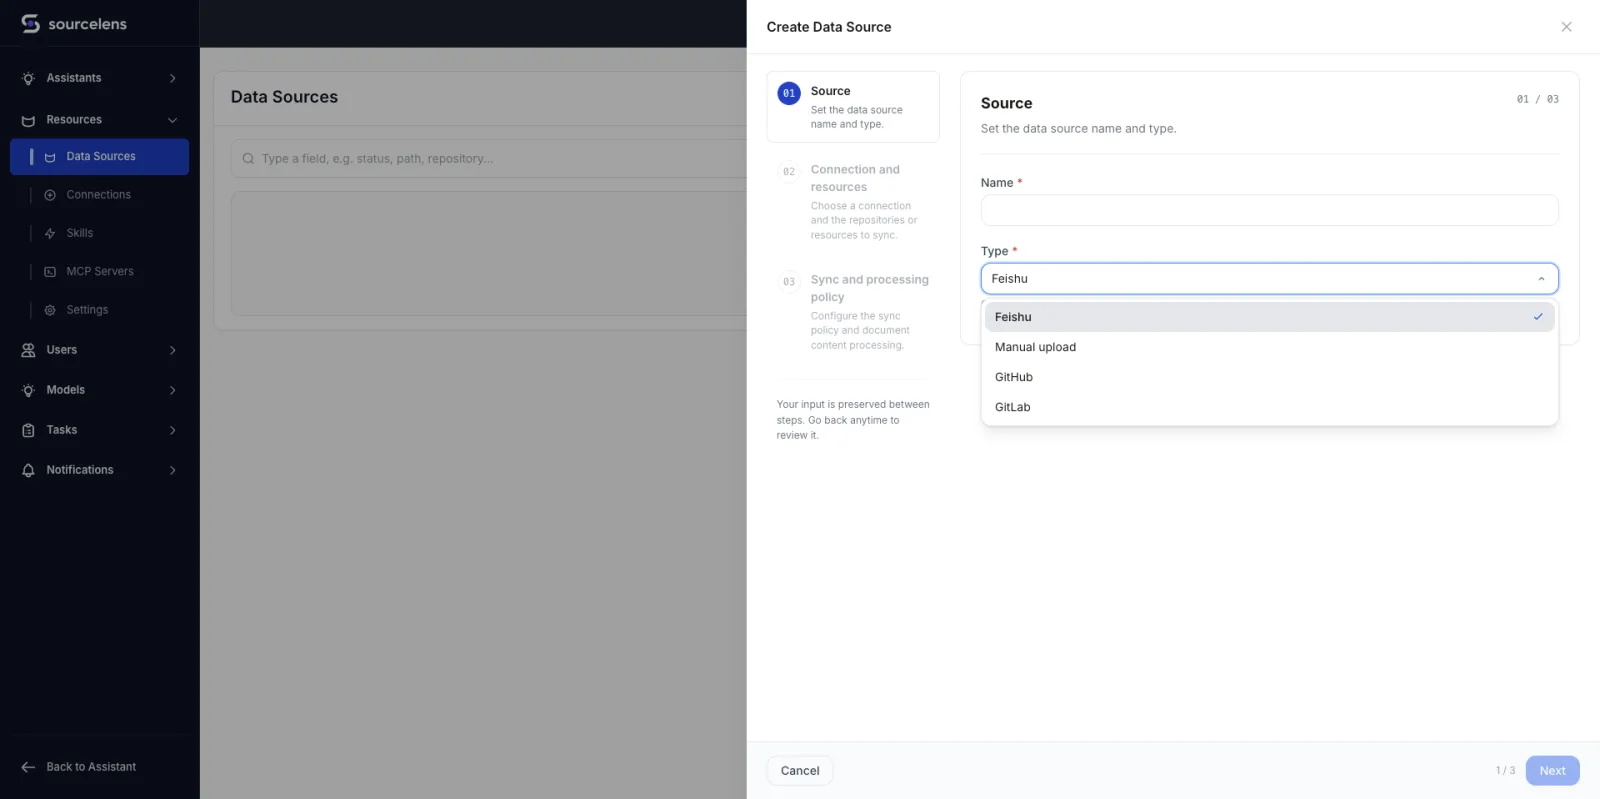
Nueva fuente de datos: ponle nombre, elige el tipo, configura la política de sincronización
Con la fuente de datos lista, se crea un asistente — cuatro pasos en total. El primero define el nombre y el modelo del agente:
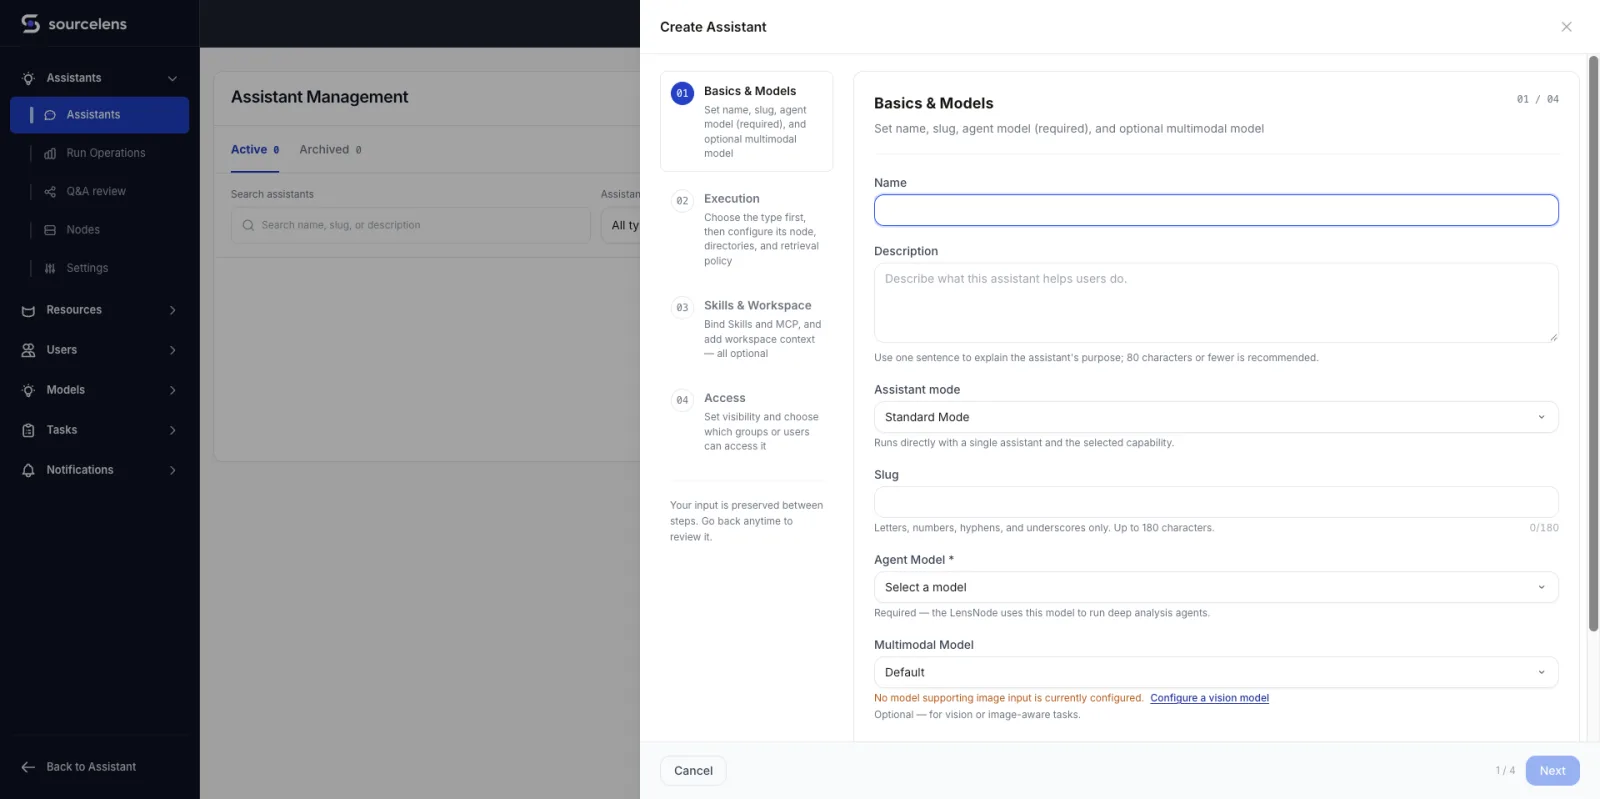
Paso uno: ponle nombre, elige un modelo de agente
El segundo paso elige el tipo de análisis (preguntas y respuestas de conocimiento / análisis de código / chat general), vincula la fuente de datos que acabas de crear, y define qué directorios y tipos de archivo excluir de la recuperación:
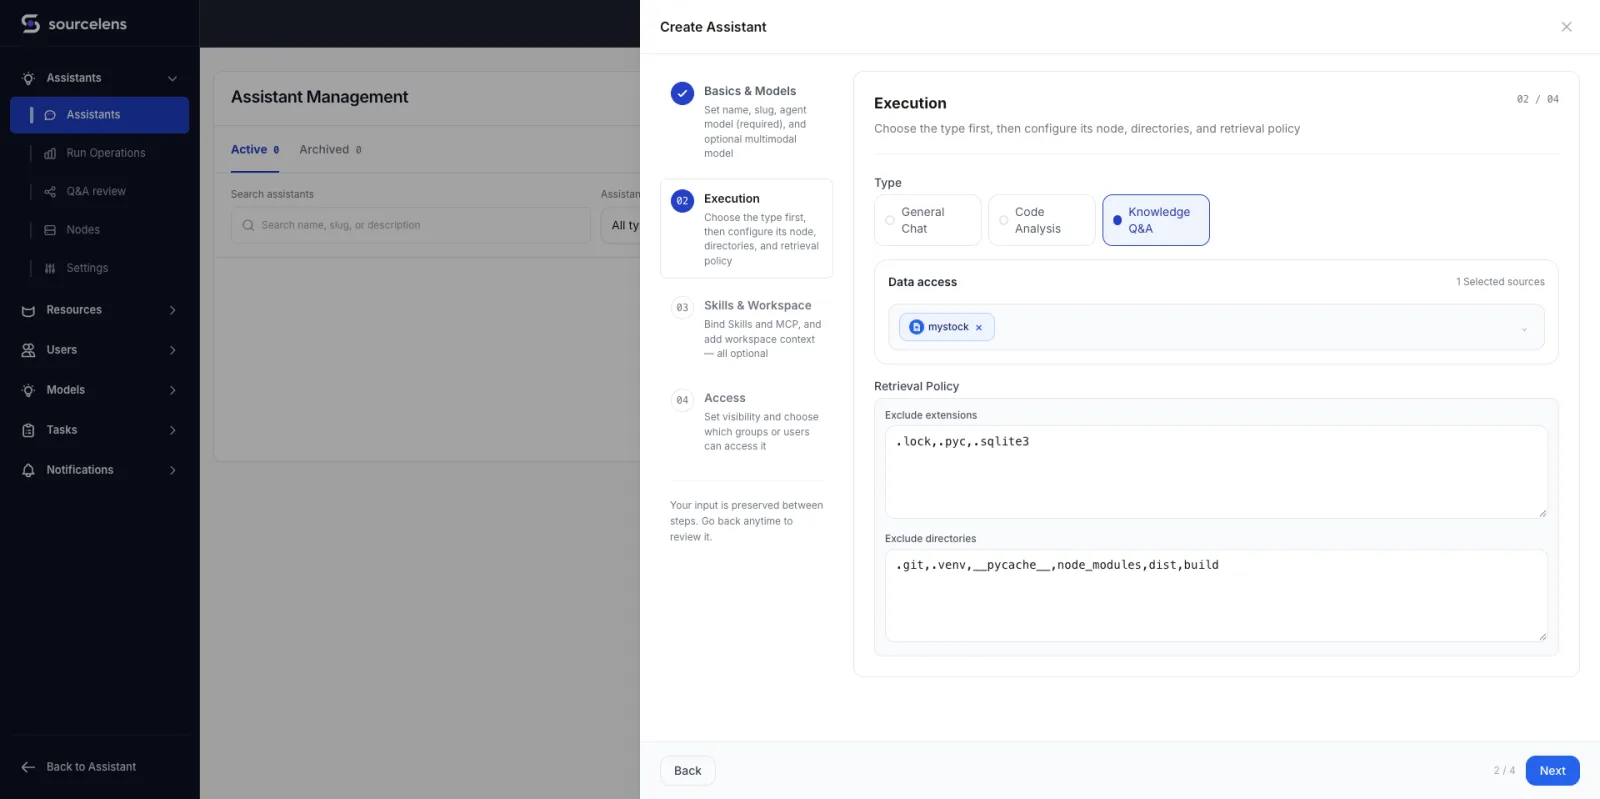
Paso dos: elige el tipo de análisis, vincula la fuente de datos, define las reglas de exclusión
El tercer paso es skills y espacio de trabajo, y es totalmente opcional: puedes escribir una guía de espacio de trabajo contándole al agente el contexto de negocio y las prioridades de búsqueda, y conectar plugins integrados, skills o servidores MCP — o saltarte todo esto y seguir adelante:
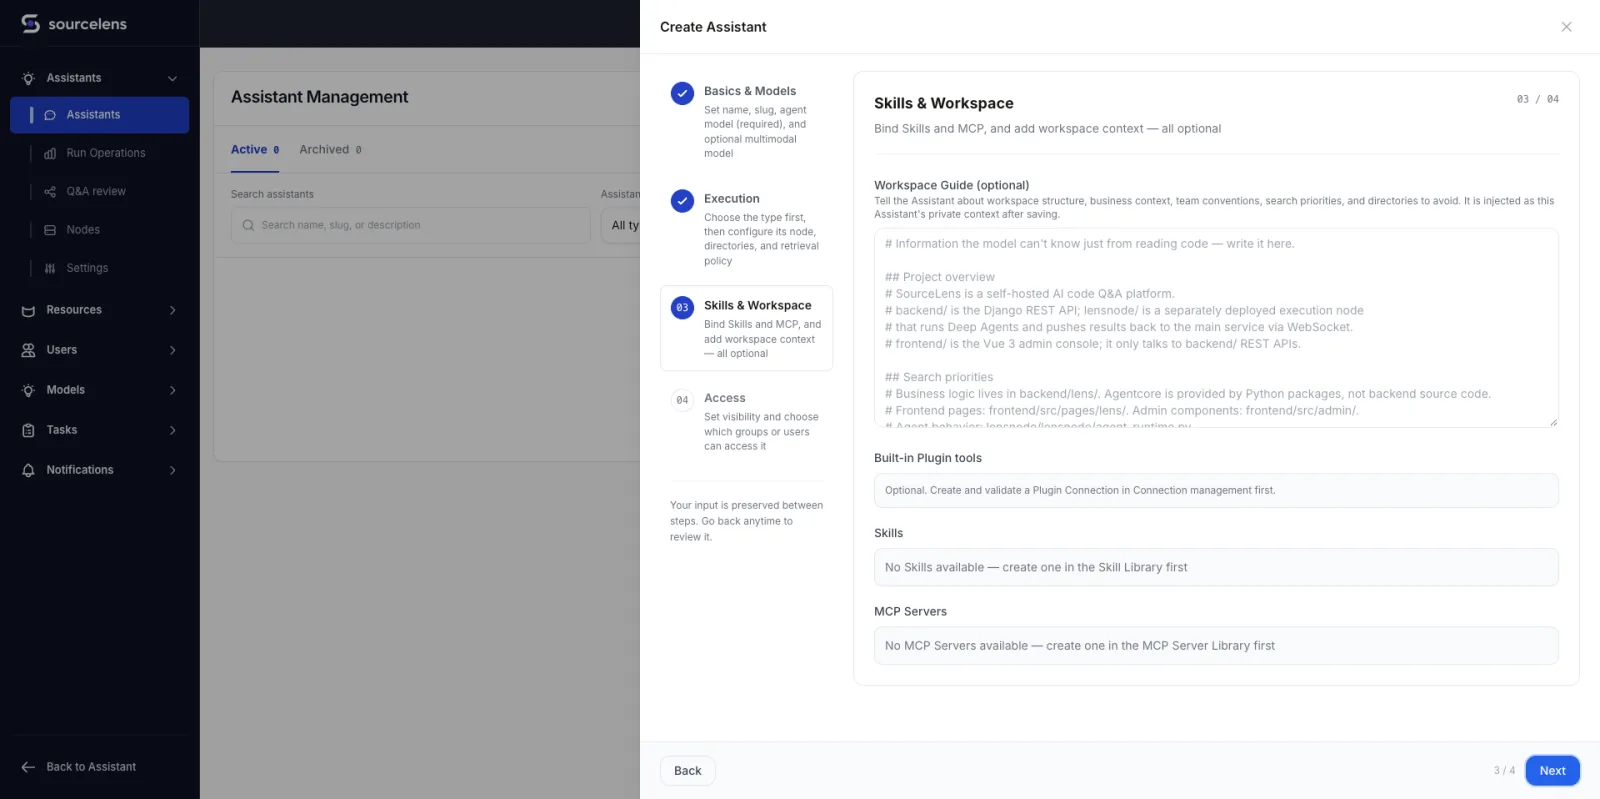
Paso tres: skills y espacio de trabajo, todo opcional
El cuarto paso define la visibilidad — pública o privada, con los administradores siempre pudiendo acceder a todos los asistentes — y al hacer clic en “Completar” termina la configuración:
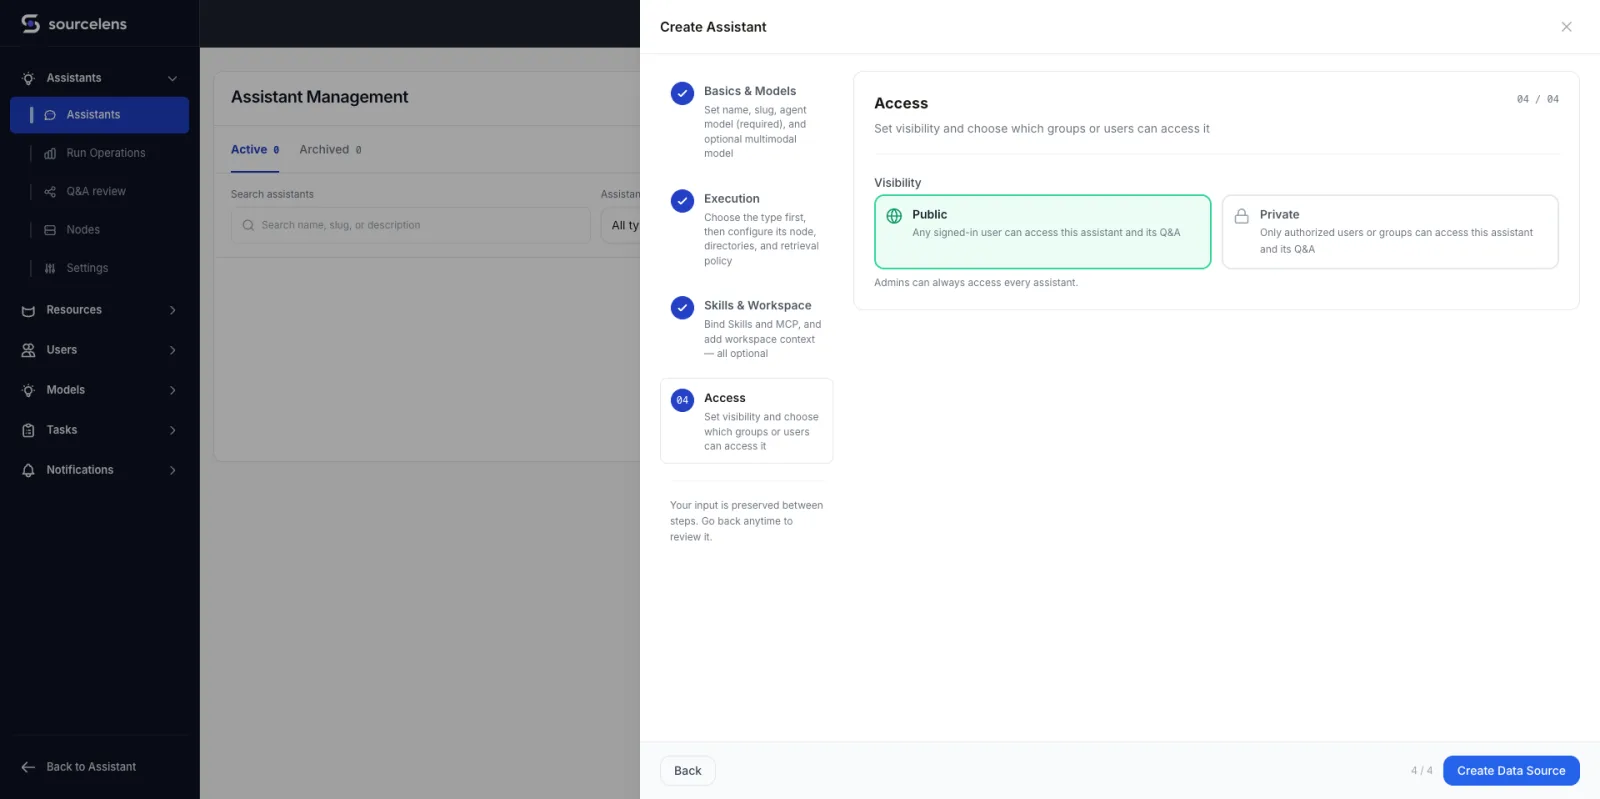
Paso cuatro: define la visibilidad, completa la configuración
Paso 3: hacer una pregunta y revisar la respuesta
Con el asistente ya creado, entras y le preguntas algo. Esta vez le dimos una pregunta deliberadamente exigente — una que requiere leer diez informes trimestrales distintos, detectar reexpresiones y citar cada cifra hasta su página exacta:
Usando solo los documentos de actualización trimestral de Tesla en este espacio de trabajo, construye una única tabla trimestral sin duplicados que cubra del Q1 2024 al Q2 2026 con las siguientes métricas:
- Producción total de vehículos
- Entregas totales de vehículos
- Brecha entre entregas y producción, calculada como entregas menos producción
- Inventario global de vehículos en días de suministro
- Almacenamiento de energía desplegado en GWh
- Margen operativo GAAP
Como cada actualización para accionistas repite varios trimestres históricos, usa el valor más reciente reportado o reexpresado disponible para cada trimestre en lugar de contar observaciones por duplicado. Cita el documento fuente y la página de cada trimestre, y señala cualquier reexpresión o cambio en la definición de las métricas.
Los diez informes trimestrales ya estaban preprocesados desde que los subimos, así que el asistente no está abriendo PDFs sin procesar en plena conversación — está razonando directamente sobre ese texto ya preprocesado. Aun así, ejecuta 30 actividades en unos ocho minutos para cruzar cada trimestre contra las actualizaciones posteriores que lo volvieron a publicar y para reconciliar las cifras por su cuenta; la mayor parte de ese tiempo es el modelo pensando, no accediendo a los datos. Corrimos esto deliberadamente en DeepSeek V4 Flash, un modelo más ligero y económico, para mantener bajo el costo — un modelo de razonamiento más potente resolvería la misma tarea más rápido:
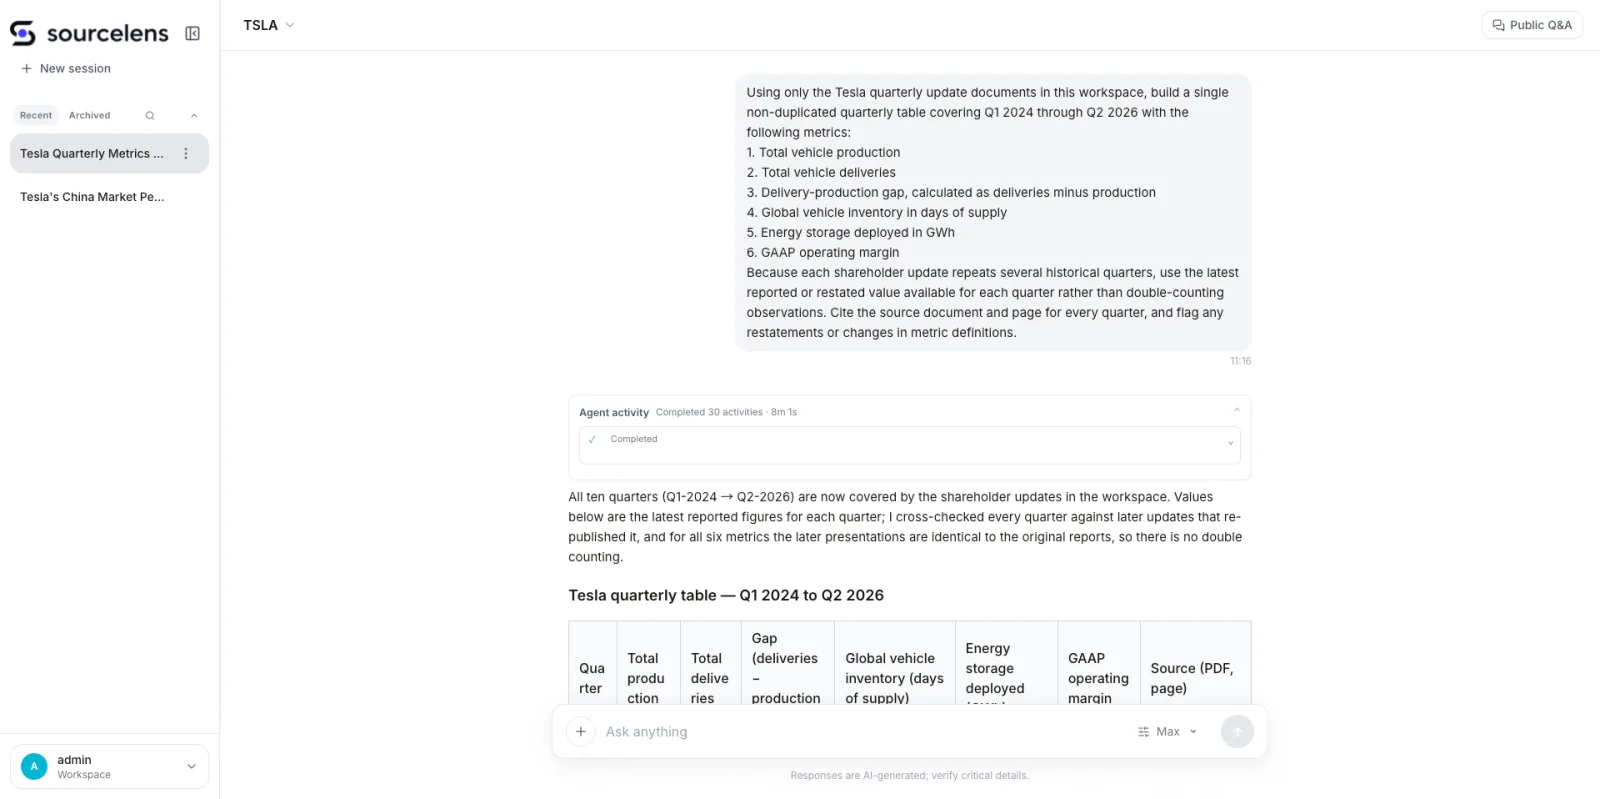
Una pregunta de diez trimestres y seis métricas — el agente pasa por 30 actividades antes de responder
Lo que devuelve es una sola tabla de diez trimestres, con cada fila citando el PDF exacto y la página de la que salió:
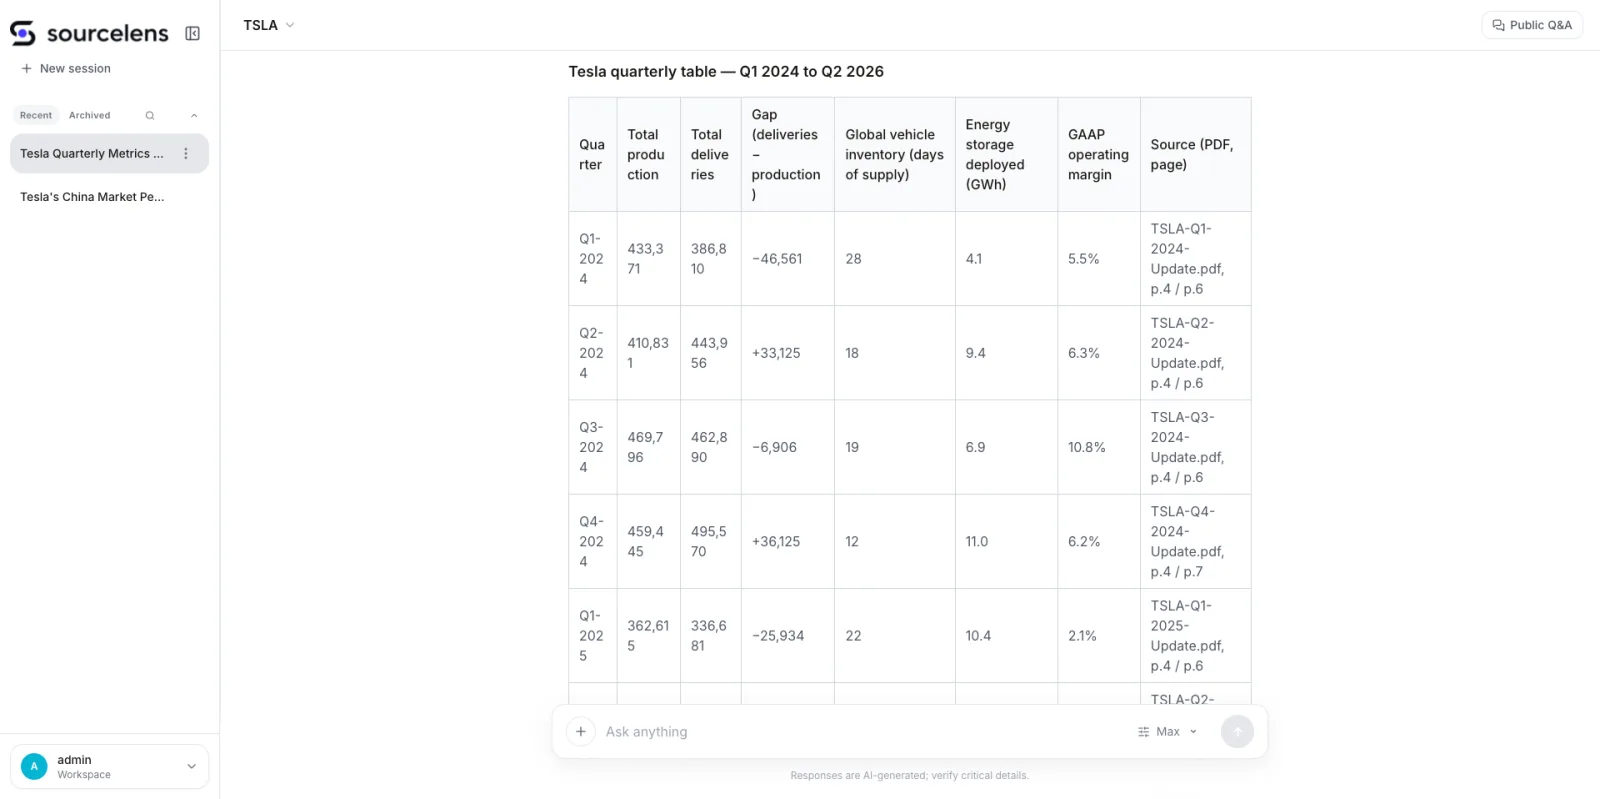
Una sola tabla, diez trimestres, cada fila citada hasta su PDF y página
Si sigues bajando, la respuesta señala exactamente dónde cambiaron de definición las cifras subyacentes entre una actualización y otra — una reexpresión contable de criptoactivos, un cambio en la presentación no-GAAP, un cambio de unidad de almacenamiento de MWh a GWh — y confirma cuáles de esos cambios sí afectan a las seis métricas pedidas y cuáles no:
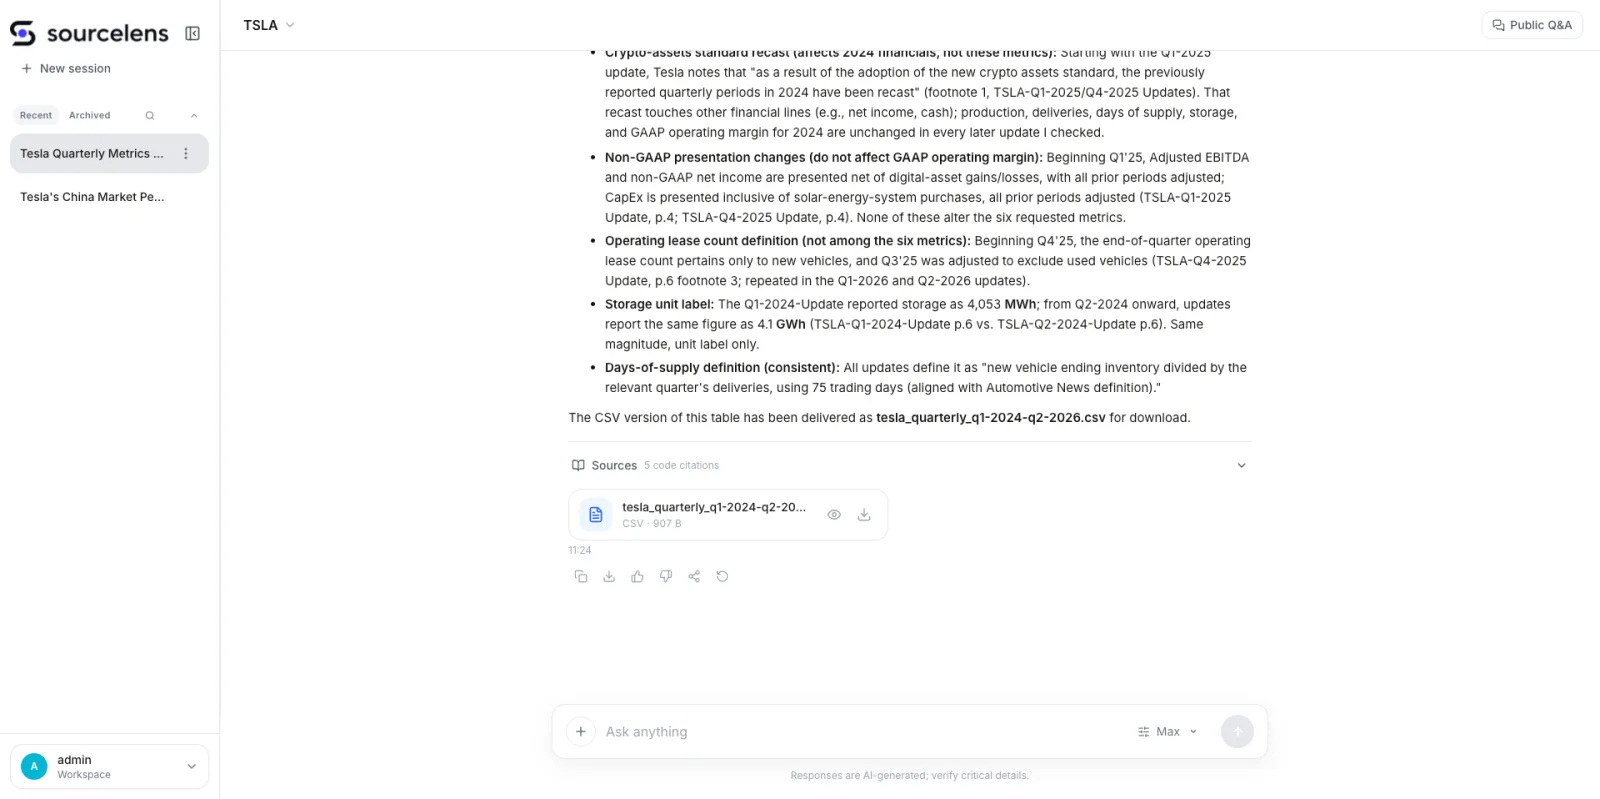
No solo responde — también te dice qué reexpresiones importan y cuáles no
También entrega los datos como un CSV descargable, para que la tabla no se quede solo dentro del chat:
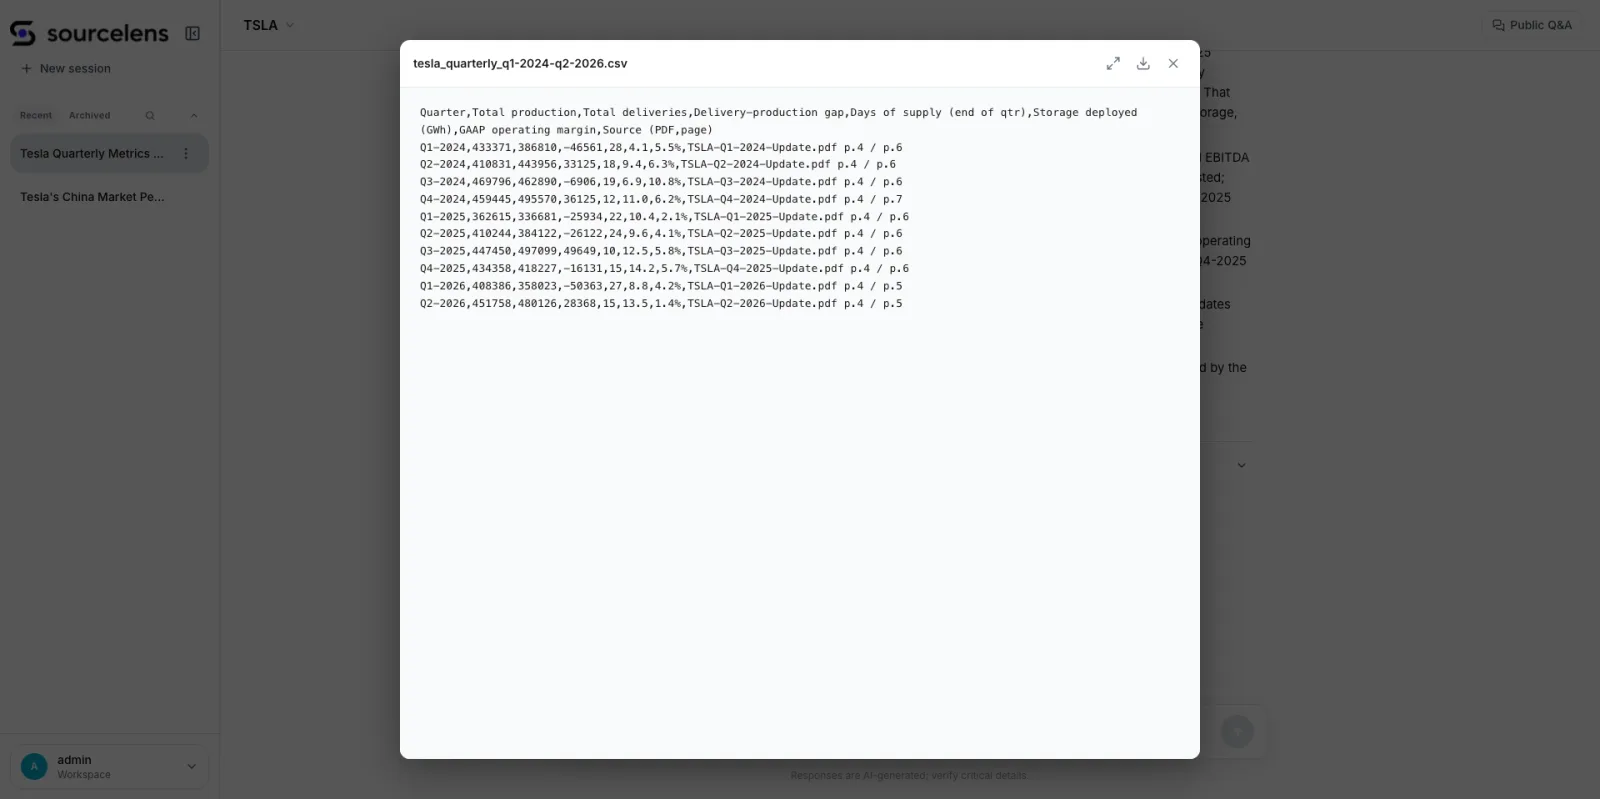
La misma tabla, entregada como un CSV listo para usar
Lo importante aquí no es solo que la respuesta final sea correcta — es que cada cifra remite a un documento y una página específicos, y cada lugar donde cambió una definición queda señalado en vez de absorberse en silencio dentro de la tabla.
En conjunto, todo el flujo es: instalar y configurar el modelo → subir datos y crear un asistente → hacer una pregunta y revisar la evidencia.
En lo que de verdad creemos: el camino del Harness Agent
Cuanto más hemos trabajado en SourceLens, más convencidos estamos de que el harness agent se está convirtiendo en una forma general de trabajar con IA: el foco del diseño está pasando de “llamar una vez menos al modelo” a “darle al agente un contexto genuinamente completo, las herramientas correctas y suficiente margen para actuar, para que de verdad resuelva bien el problema”. Codex y Work Buddy ya demostraron que este patrón funciona — pero resuelven el problema para una persona. SourceLens busca resolverlo para una empresa. Nos preguntan mucho la diferencia, y en la práctica se reduce a esto:
| Codex / Work Buddy | SourceLens | |
|---|---|---|
| Datos con los que trabaja | Los archivos locales de una persona | Los datos compartidos de una empresa |
| Cómo se pone en marcha | Cada quien instala y configura su propio modelo | Un administrador lo configura una vez; el resto solo abre un enlace |
| Gobernanza | Herramienta personal — no aplica realmente | Fuentes de datos acotadas por asistente, control de acceso aplicado, cada respuesta rastreable |
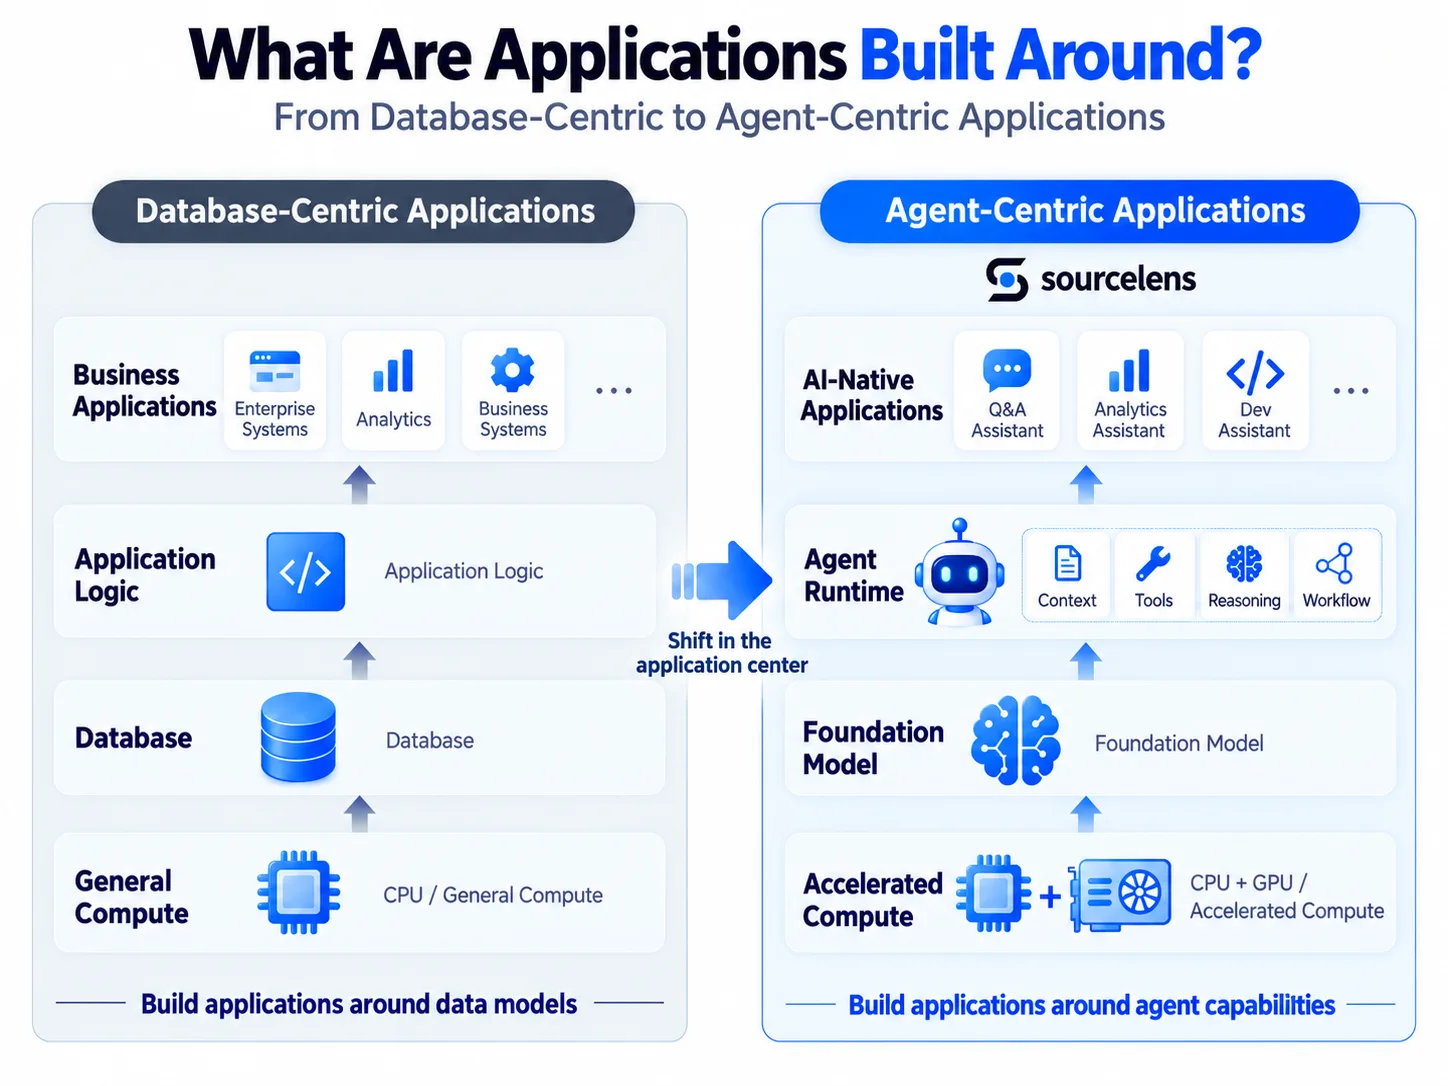
La era de las bases de datos construía aplicaciones alrededor de un modelo de datos; la era de la IA las construye alrededor de la capacidad del agente
Hay otro juicio del que cada vez estamos más seguros: si las últimas décadas le pertenecieron a la base de datos, lo que viene después de la IA es la era en la que los datos no estructurados finalmente se redescubren. Documentos de Word, presentaciones, PDFs, correos, notas de reuniones, imágenes y código antes eran cosas que solo podías guardar y buscar. La IA es lo primero que le permite a una máquina realmente leerlos, conectarlos y razonar sobre ellos directamente. Tampoco tenemos prisa por forzar todo eso dentro de una ontología perfecta desde el principio — funciona mejor dejar que el agente entre primero a los datos reales, que busque, lea y razone, y solo después decidir qué vale la pena formalizar. En la era de las bases de datos, los humanos estructuraban el mundo primero y dejaban que las máquinas calcularan después. En la era de la IA, las máquinas pueden entrar directo a los datos no estructurados, encontrar las relaciones por sí mismas, construir contexto, y convertirlo en conocimiento.
Únete a la comunidad de código abierto de SourceLens
Si te encuentras con algún problema al probarlo, quieres contribuir, o simplemente quieres platicar sobre el proyecto, encuéntranos aquí:
- GitHub: https://github.com/oneprolabs/sourcelens
- Twitter/X: @oneprolabs
Si usas WeChat, también puedes unirte a nuestro grupo de WeChat: solo escanea el código QR de abajo con WeChat.
Escanea con WeChat para unirte al grupo de OneProLabs